[Astro] #159 WASM Inspector — .wasmの中身をバイト単位で覗く(WAT・hex・DWARFソース行の3方向連動)
はじめに
前回(#158)は、Tree-sitter の WASM でソースコードの構文木を覗くツールを作りました。
[Astro] #158 AST Inspector — Tree-sitter WASMで構文木を覗く(Queryとインクリメンタルパースの可視化付き) // PROTOCOL.LAIN
Tree-sitter(web-tree-sitter)をWASMで動かし、ソースコードの構文木をブラウザだけで覗けるツールを作りました。
lain-lab.com今回は WASM Inspector です。
このサイトのツールは、ほとんどが WASM で動いています。
FFmpeg、libjxl、laz-perf、HarfBuzz、Tree-sitter……。
ところが、その .wasm の中身を覗くツールは、まだありませんでした。
今回はそれを作ります。
前回は「ソースコード → 構文木」でした。
今回はコンパイルの出口側で、「ソースコード → 機械語(WASM のバイトコード)」の結果を、バイト単位で読み下す側です。#157 の Font Inspector で TrueType 命令の逆アセンブラを書いたのと、同じ系統の作業になります。
きっかけのひとつに、Qiita で見かけた記事があります。

それでもワイはWasmをデバッグしたいんや! エラーすら吐かず沈黙するブラウザと3日3晩格闘して和解した話 - Qiita
はじめに:大反響への感謝 前回の記事「うっかり世界最強のWasmコンパイラを作ってしまった件」では、予想を遥かに超える反響をいただき、なんとQiitaの週間お気に入りランキングで2位を達成しました! 累計PVも45,000PVを突破し、GitHubリポジトリ(hike-l...
qiita.com自作言語のコンパイラから DWARF(デバッグ情報)を自前で 1 バイトずつ組み立てたところ、オフセットが 1 バイトずれるだけで Chrome DevTools が何も言わずにソースを表示しなくなり、16 進ダンプを睨みながらずれを探した、という話でした。
それでもワイはWasmをデバッグしたいんや! エラーすら吐かず沈黙するブラウザと3日3晩格闘して和解した話 - Qiita
「.wasm の中身を、バイトと意味を対応させて見たい」という需要は、実際にあるわけです。
完成画面
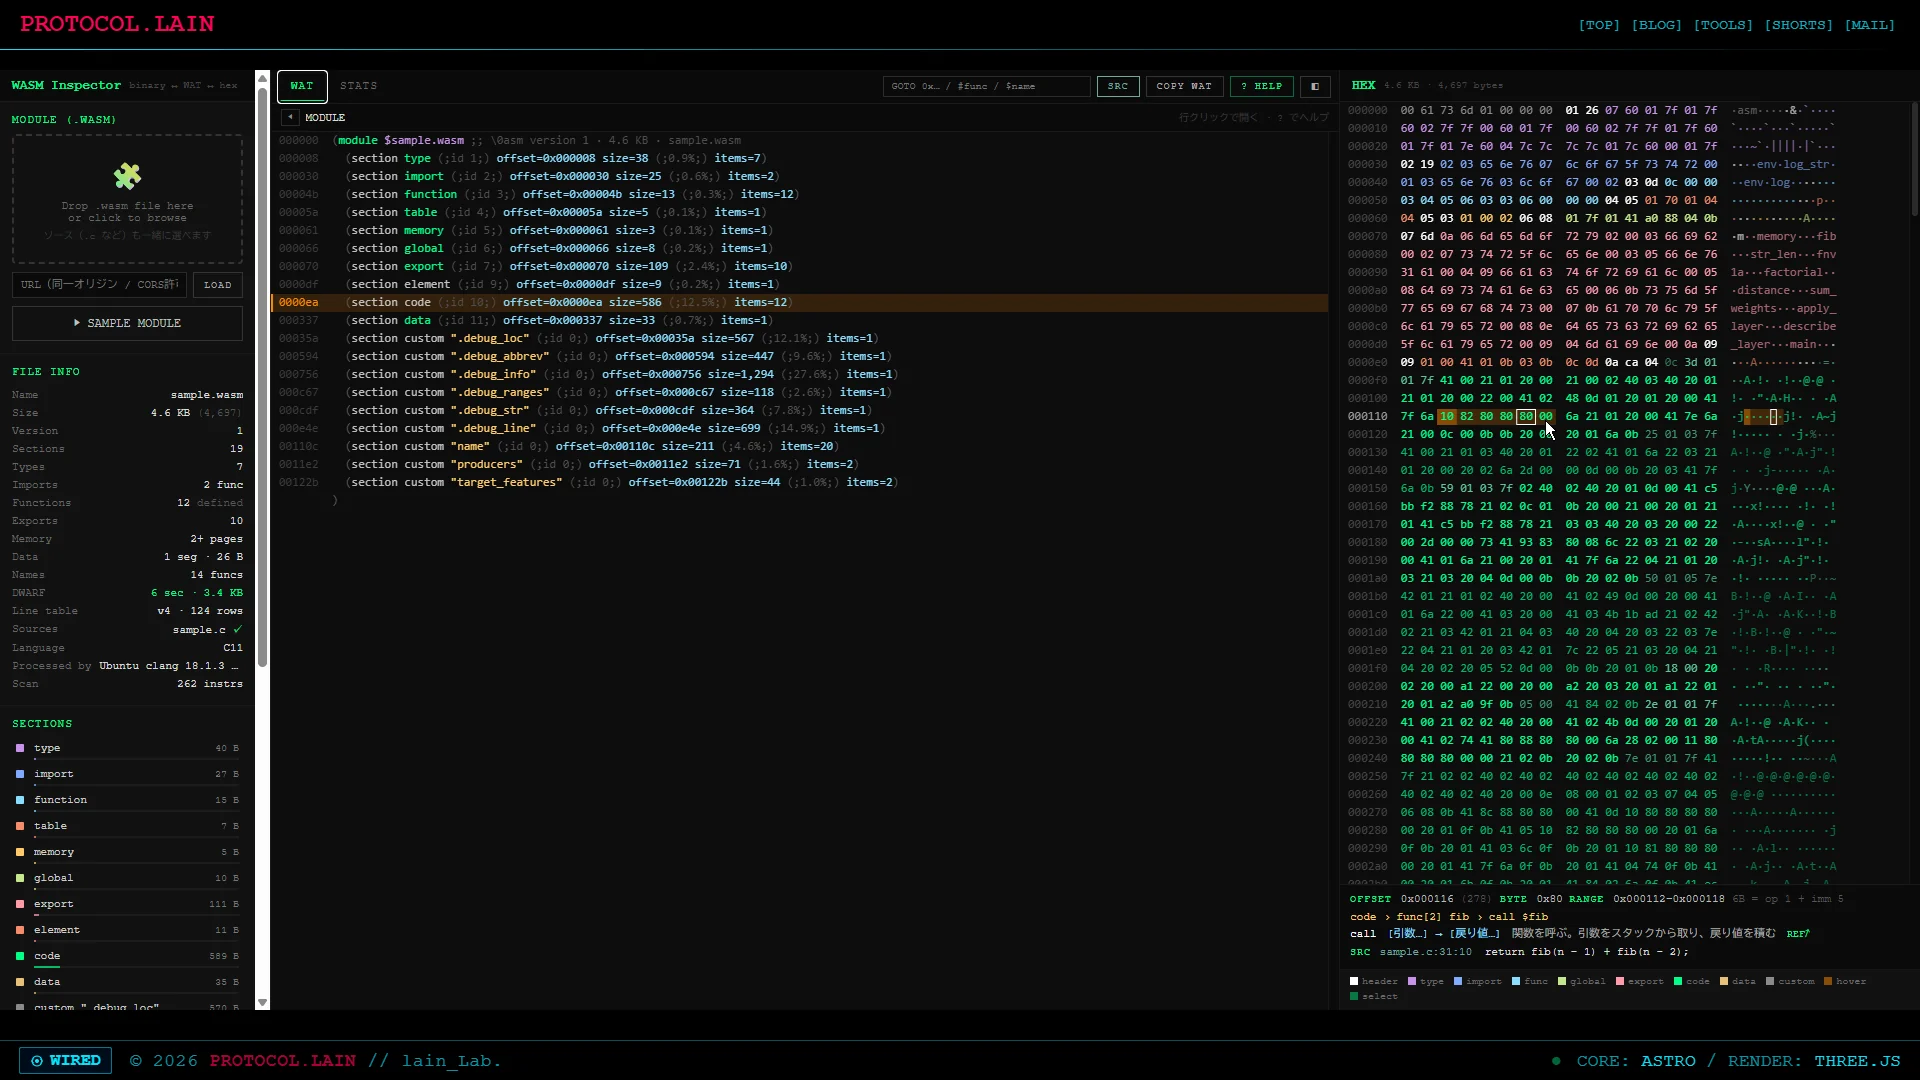
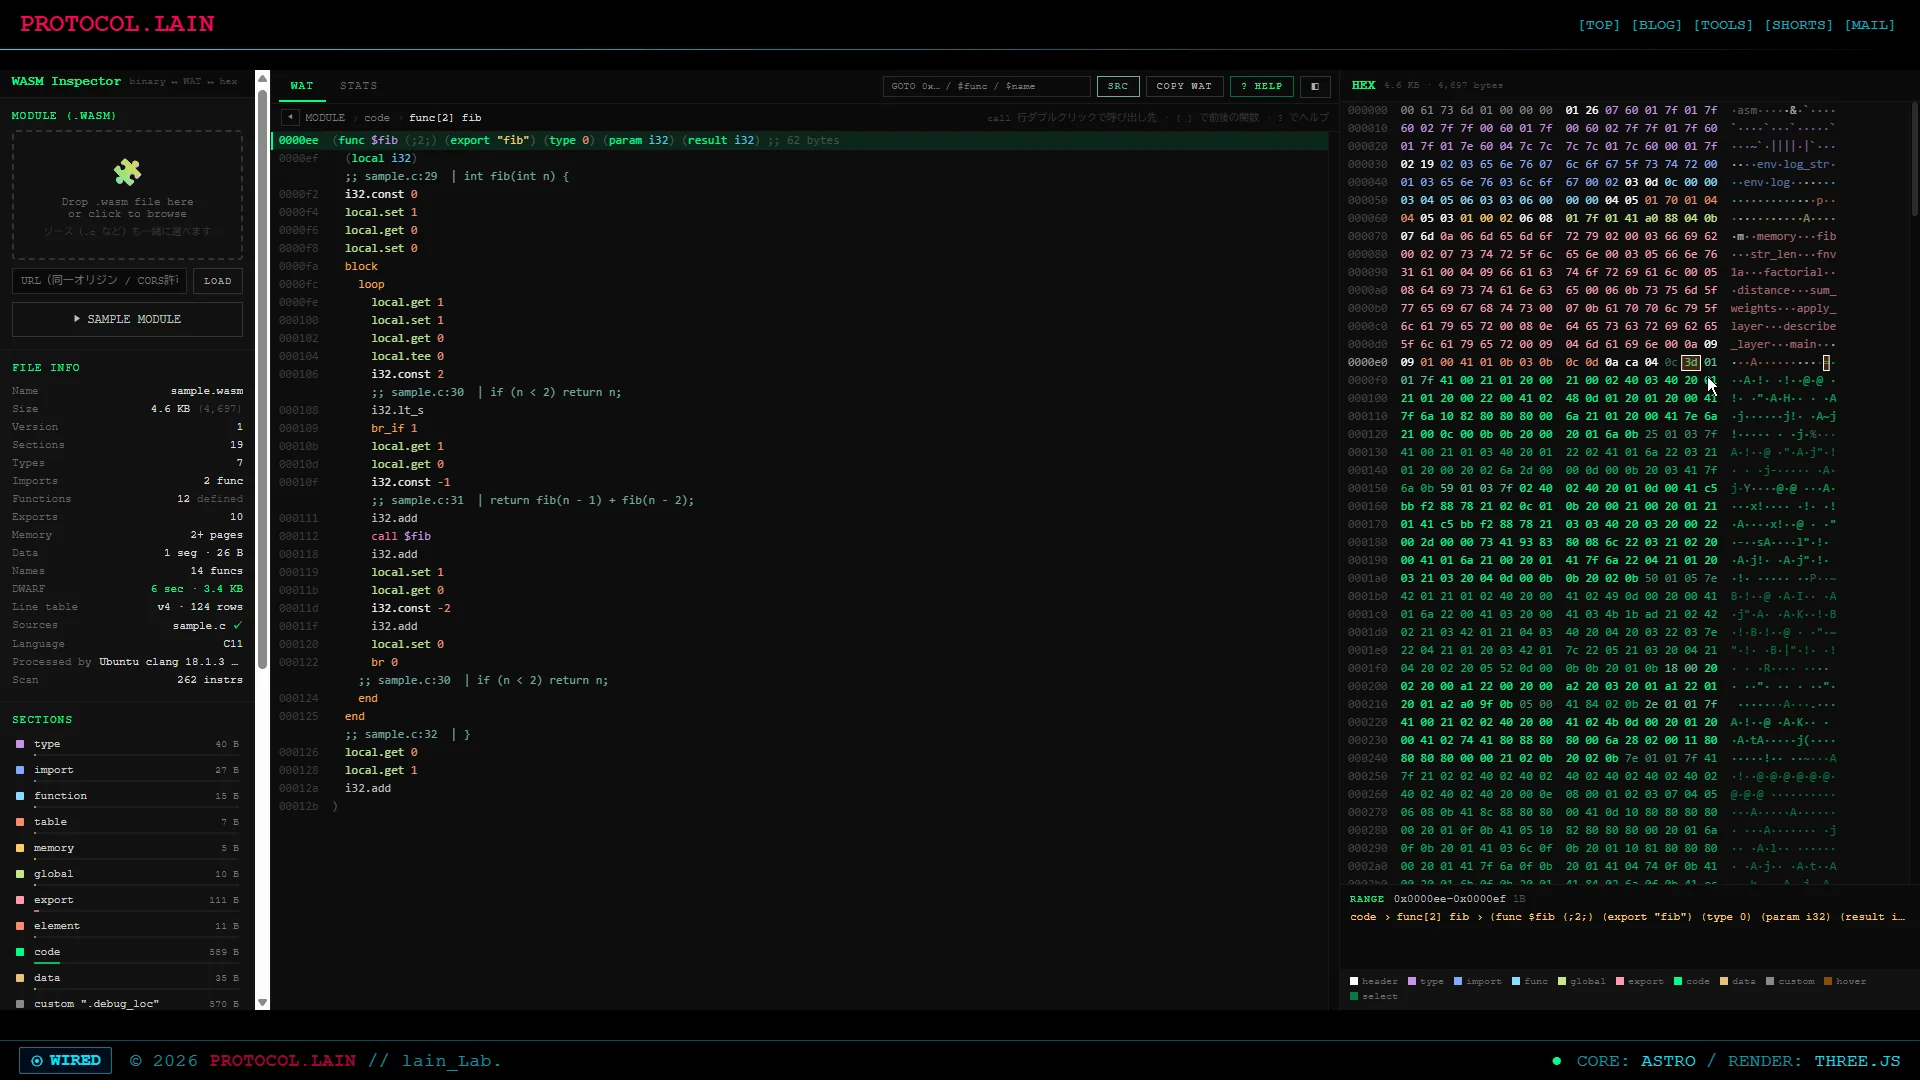
WASM Inspector — WAT・hex・ソースの連動
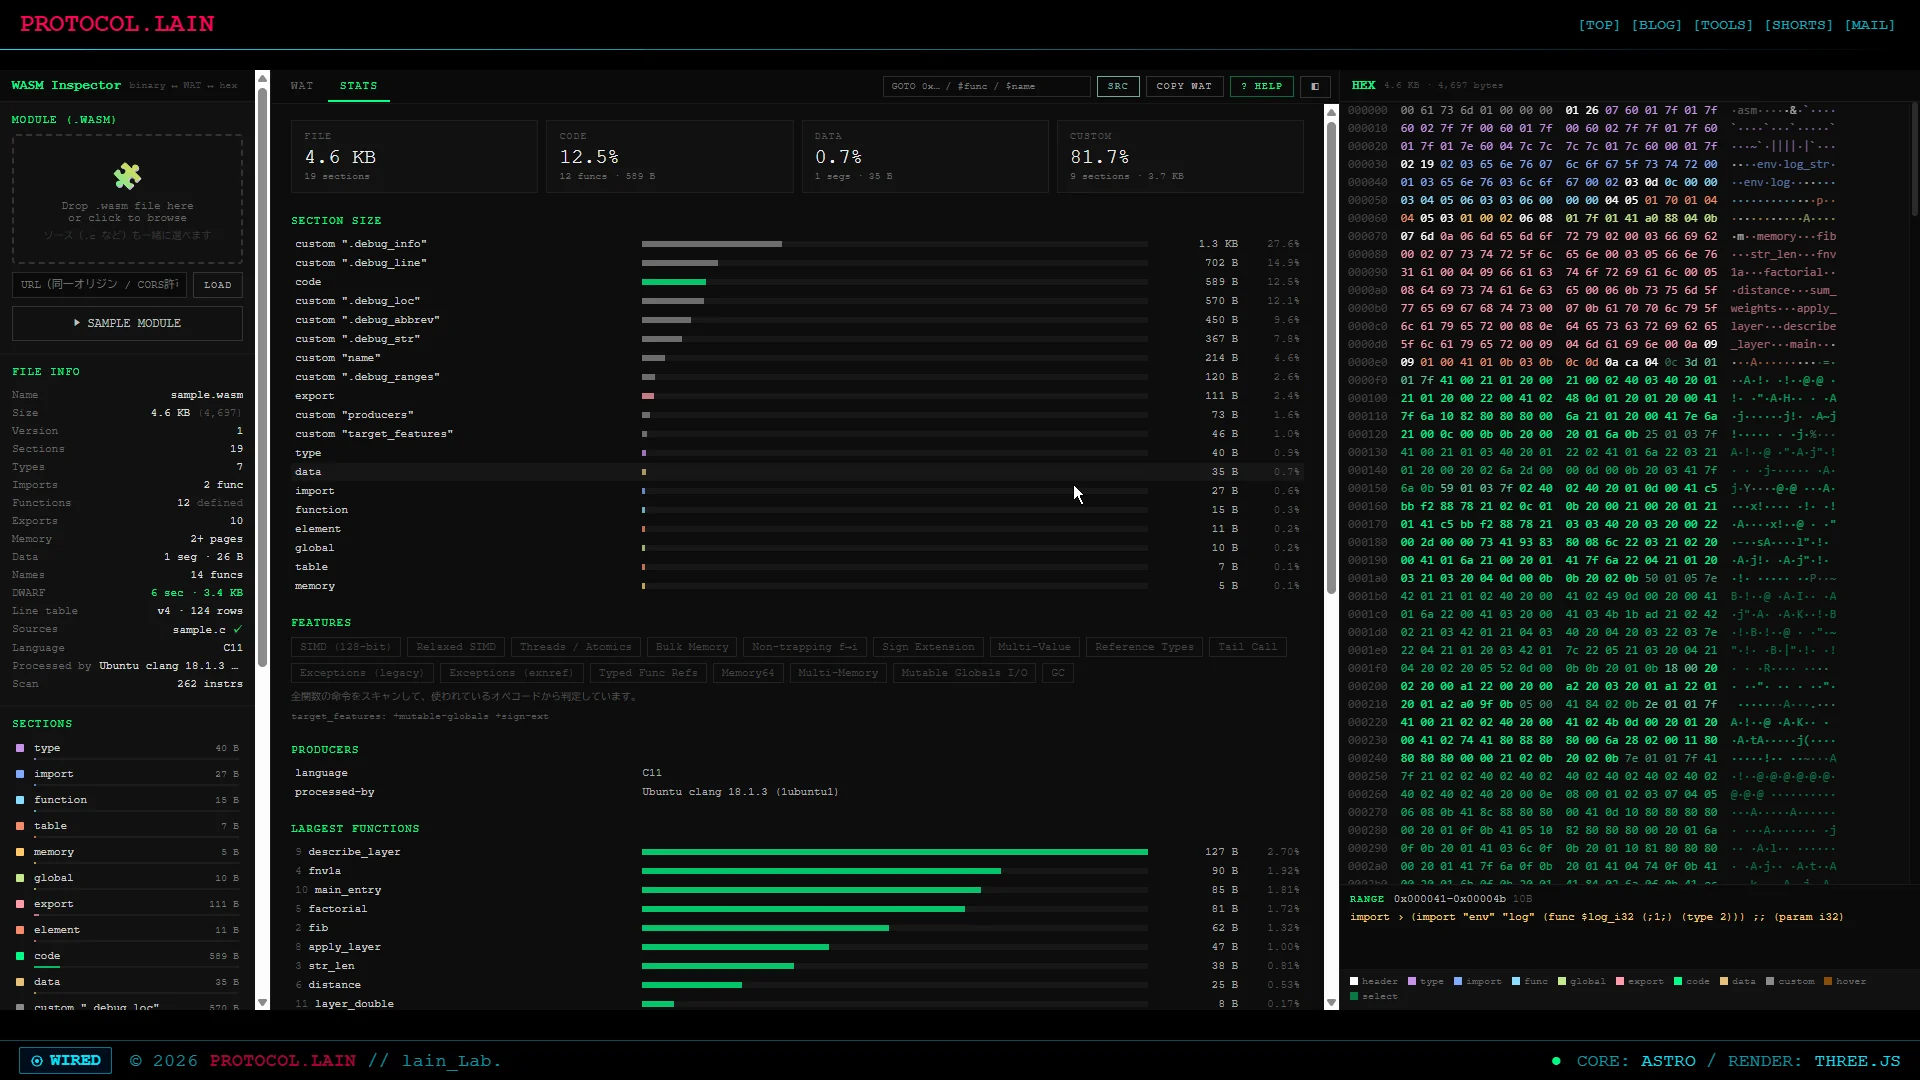
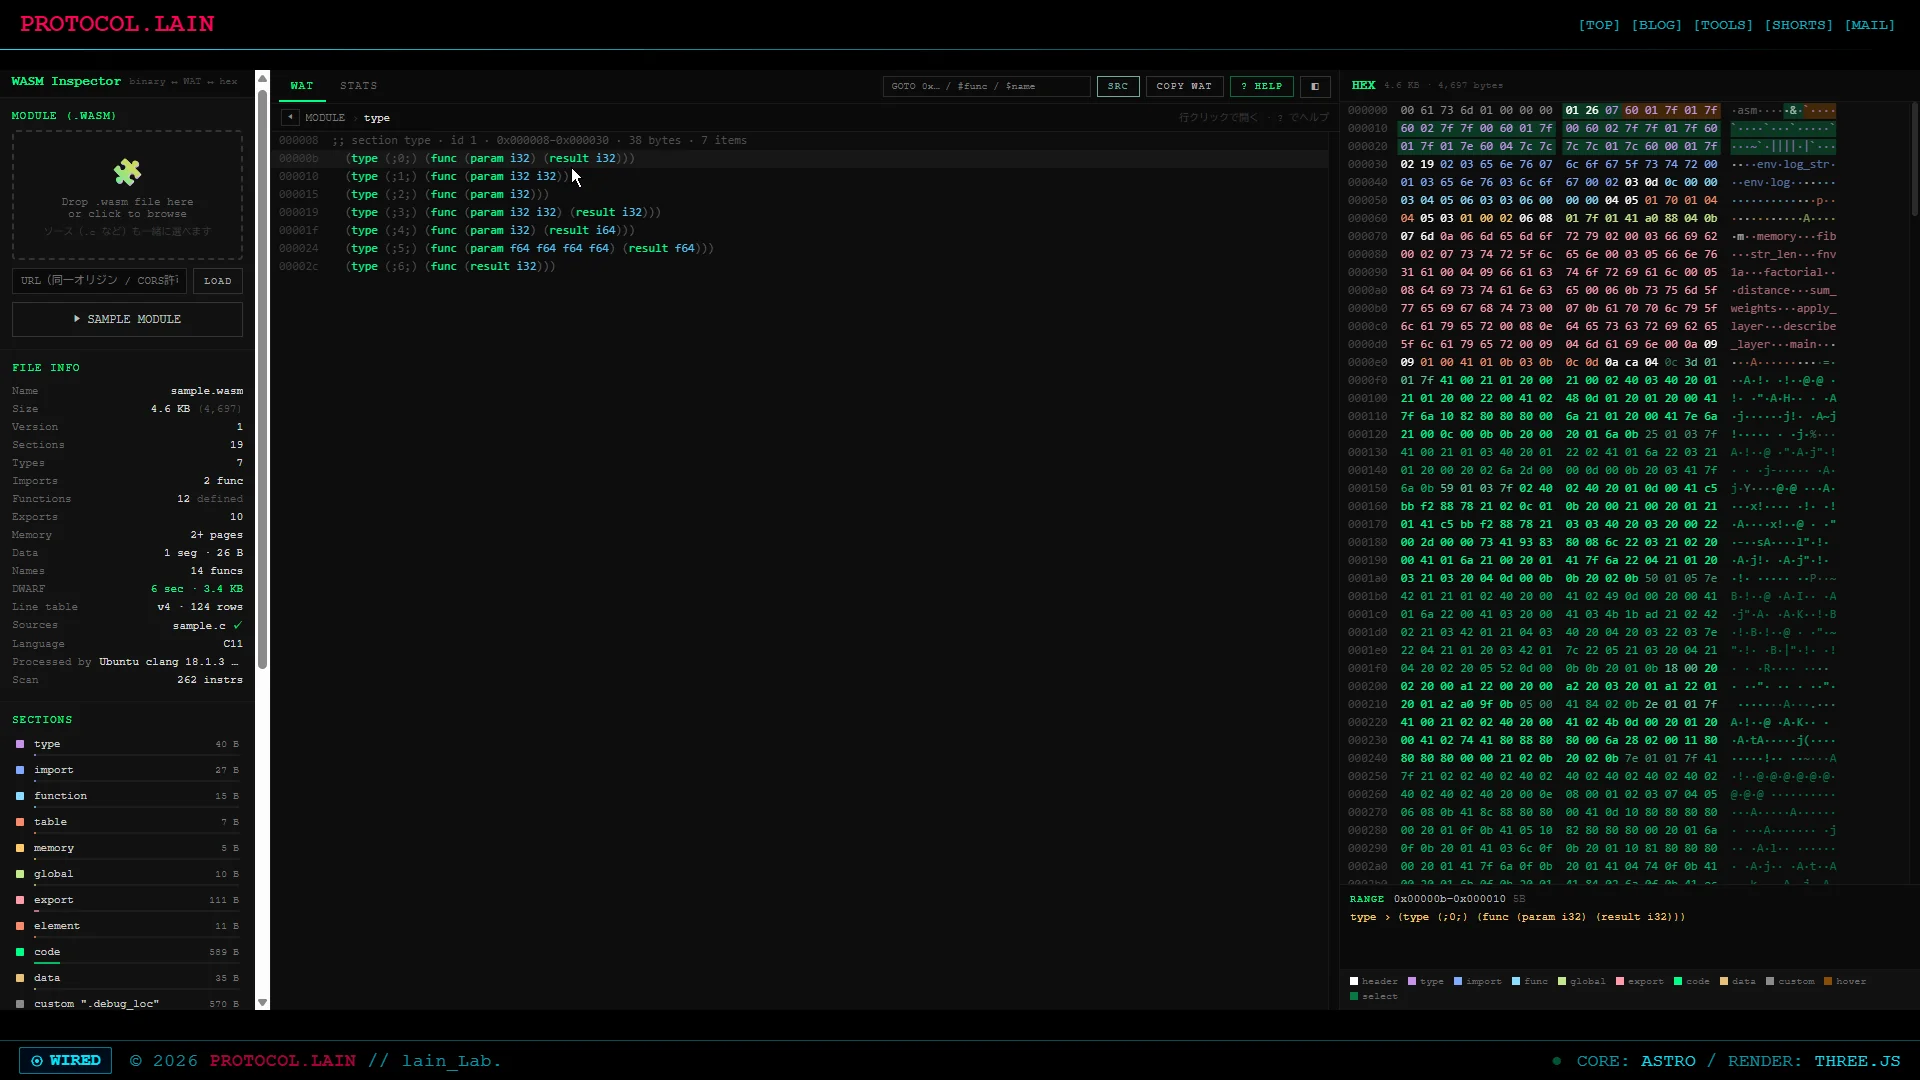
WASM Inspector — STATS(サイズの内訳・機能判定・オペコード頻度)
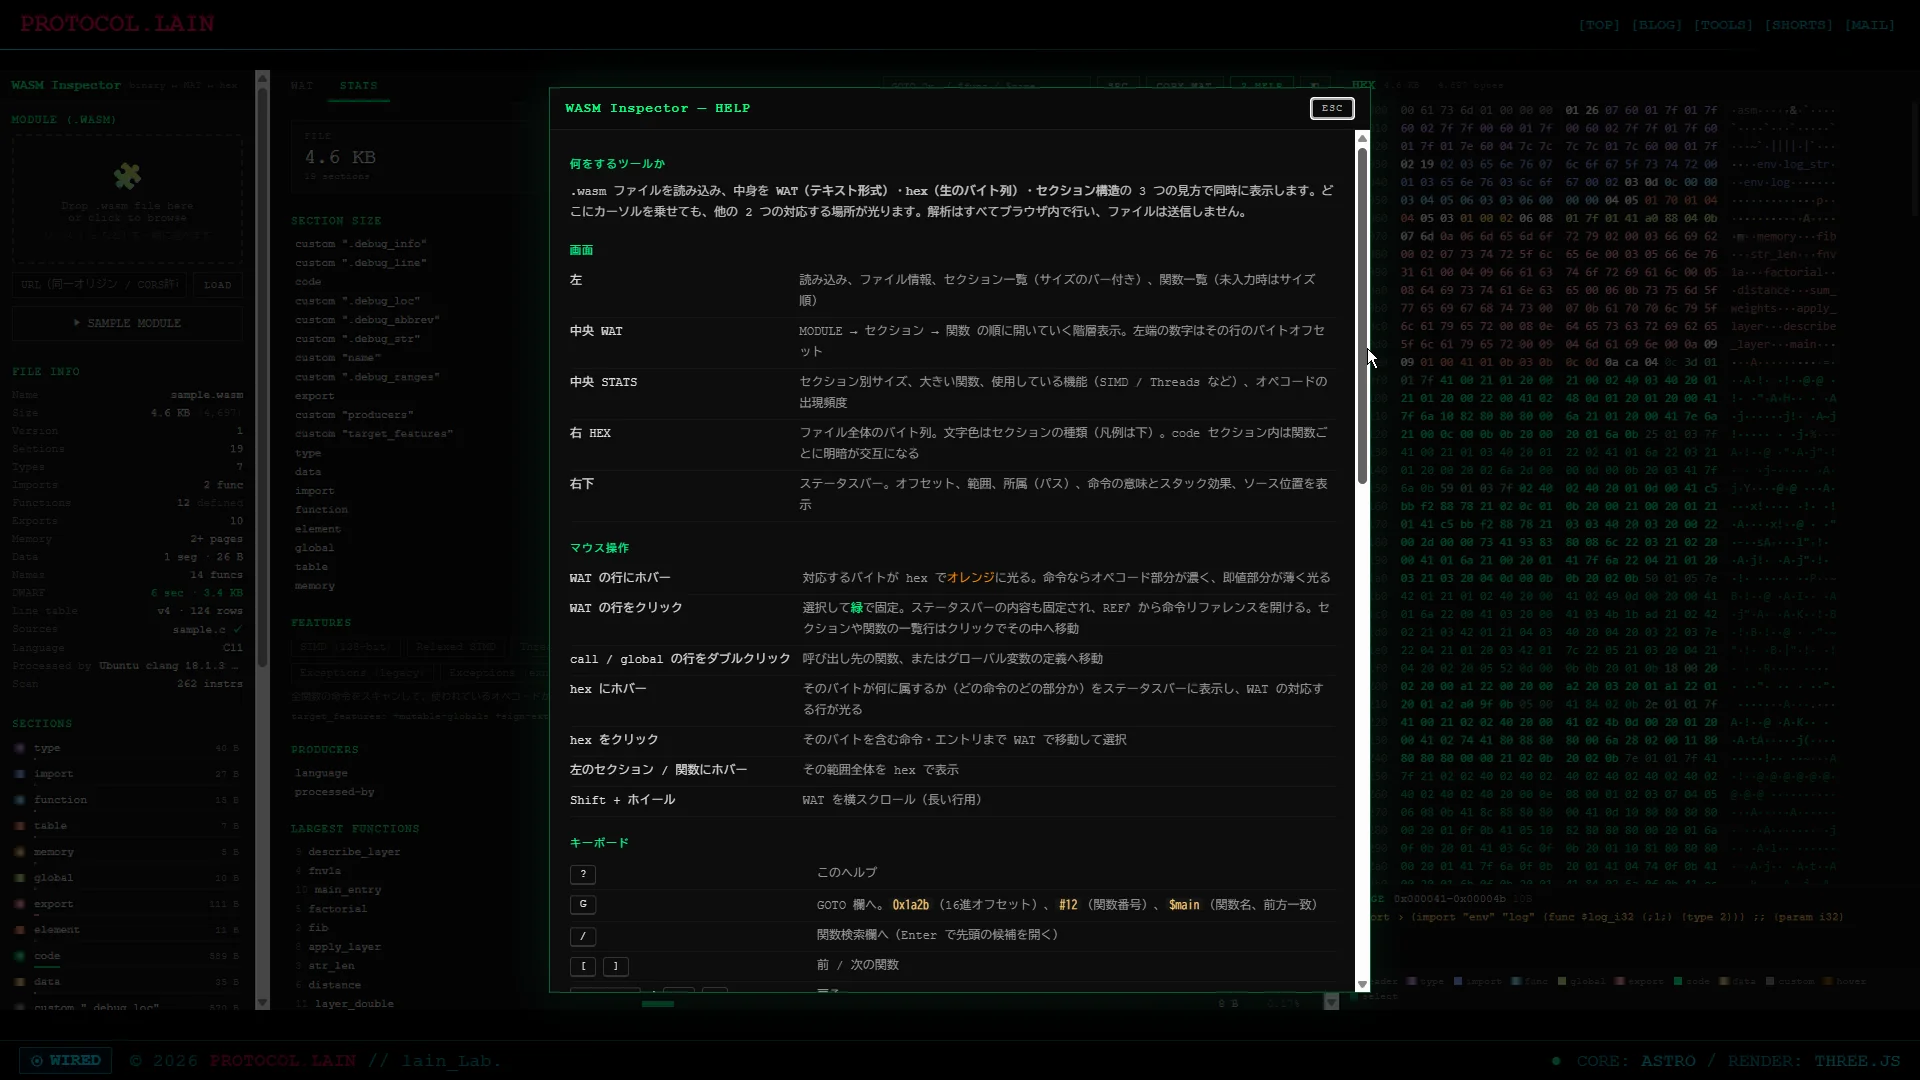
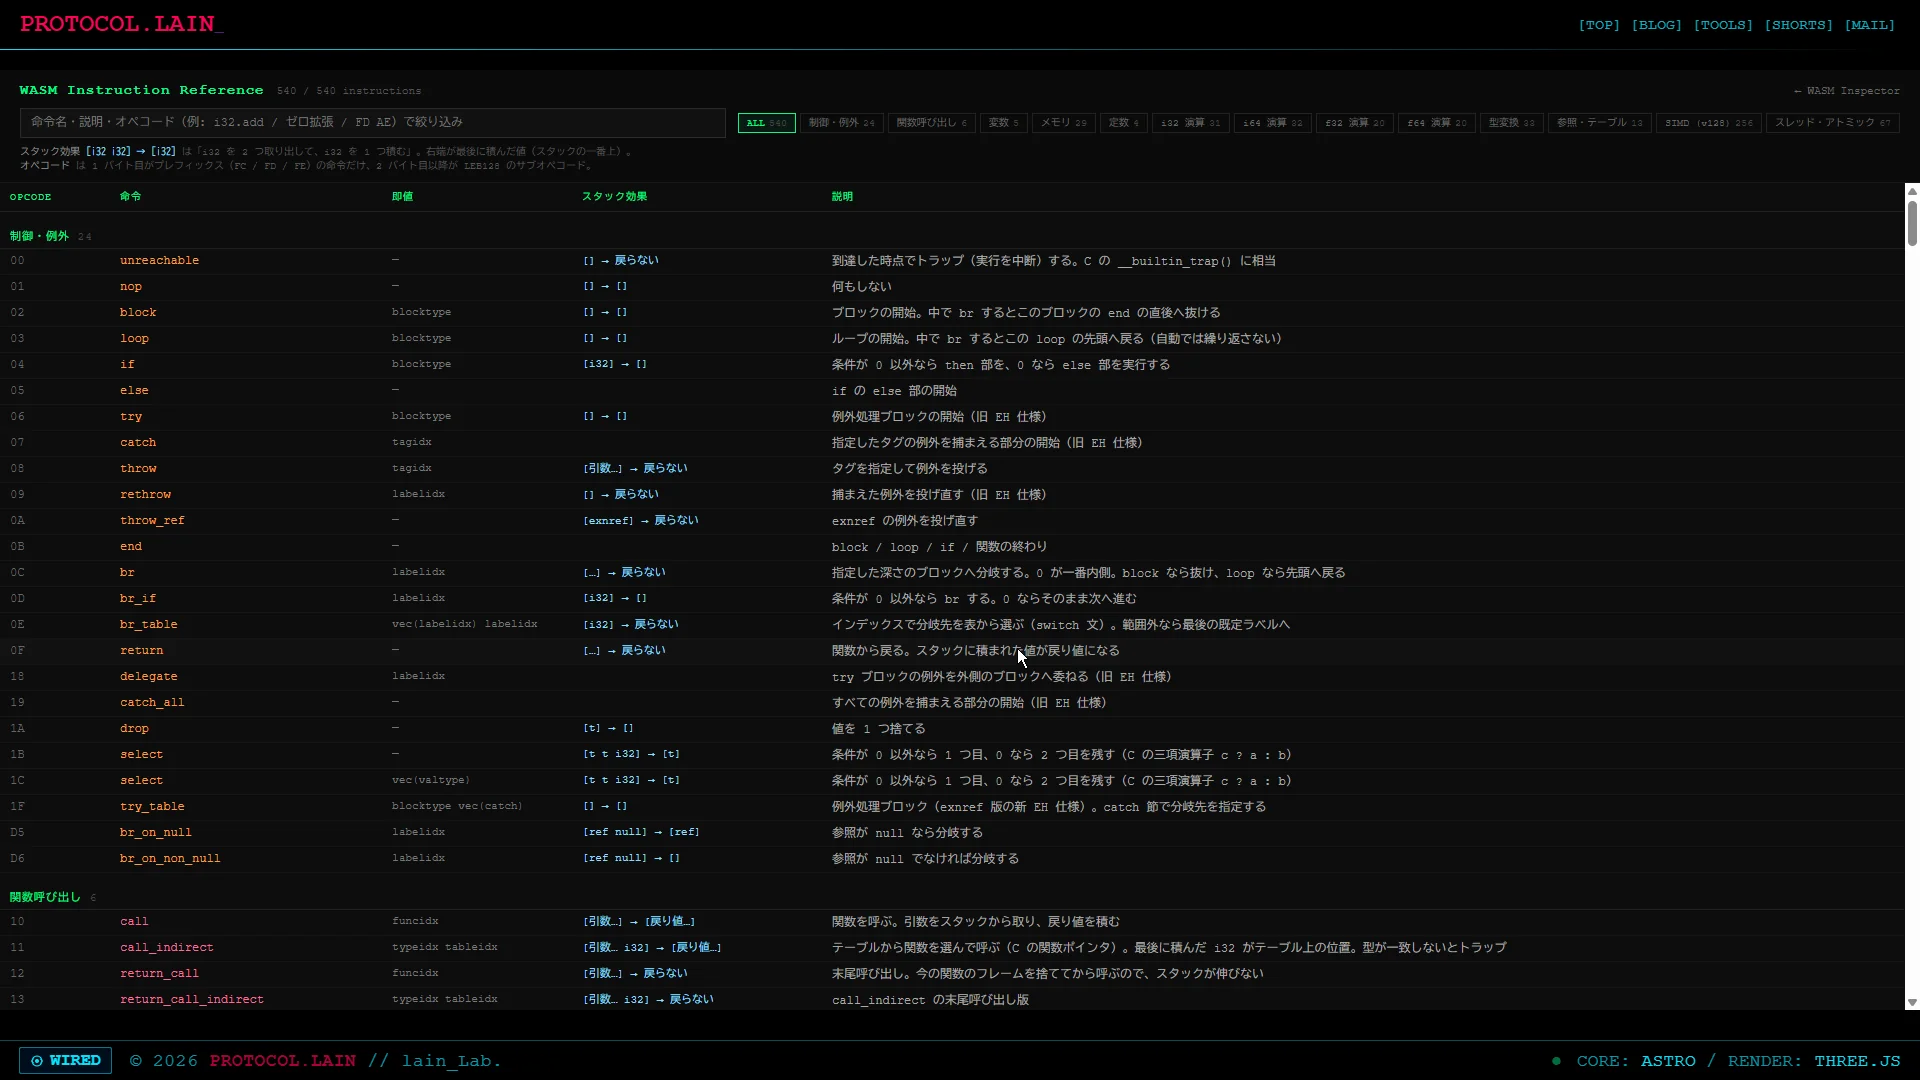
WASM Instruction - HELP / Reference
操作動画
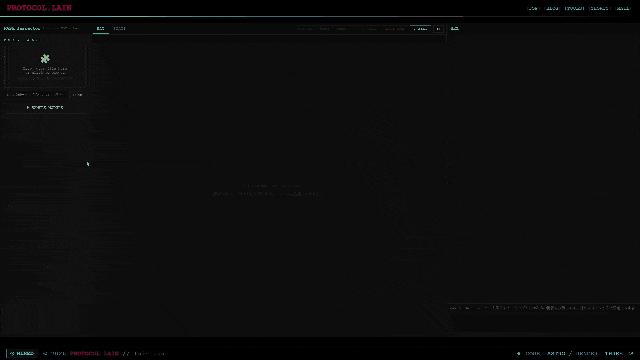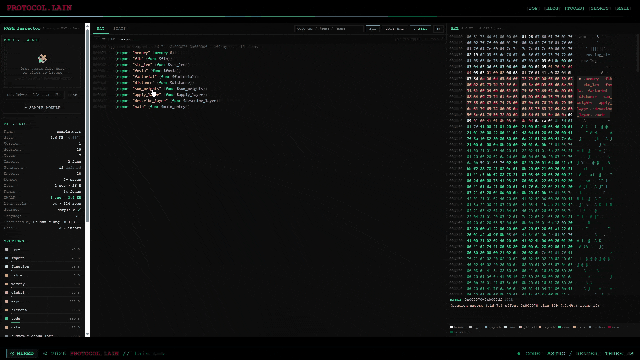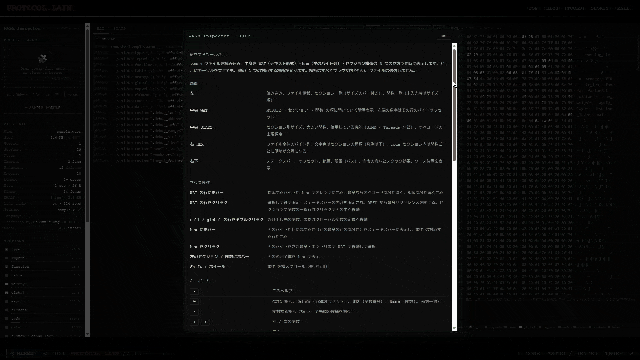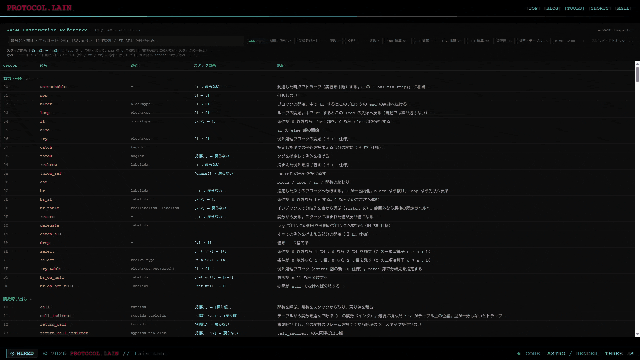
画面は、左がファイル情報・セクション一覧・関数一覧、中央が WAT(と STATS)、右が hex です。
できることは次のとおりです。
.wasmをドロップ / ファイル選択 / URL で読み込み(解析はすべてブラウザ内)- MODULE → セクション → 関数 の順に開いていく WAT 表示
- WAT の行にホバーすると、対応するバイトが hex で光る(オペコードは濃く、即値は薄く)
- hex のバイトにホバーすると、そのバイトが「どの関数の、どの命令の、どの部分か」を表示し、WAT の行も光る
callの行をダブルクリックで呼び出し先へ。戻る・前後の関数・オフセット指定のジャンプ- STATS:セクション別サイズ、大きい関数、使用している機能(SIMD / Threads など)、オペコードの出現頻度
- 命令の意味とスタック効果をステータスバーに表示、別ページの命令リファレンス(全 540 命令)
- v1.1:DWARF の行テーブルを読み、WAT の間に元のソース行(
;; sample.c:30 │ if (n < 2) return n;)を挟む
構成
いつもどおり、ページは Astro、処理は public/ に置いた素の JS です。今回は WASM のライブラリを 1 つも使っていません。
my-astro-project/
├─ src/pages/
│   ├─ wasm-inspector.astro             UI・CSS・HELP ダイアログ
│   └─ wasm-inspector-reference.astro   命令リファレンスのページ
└─ public/
    └─ wasm-inspector/
        ├─ wasm-core.js        パーサー・逆アセンブラ・DWARF 行テーブル(約 1,600 行)
        ├─ wasm-inspector.js   画面(約 1,400 行)
        ├─ wasm-opdoc.js       命令の説明とスタック効果(約 300 行)
        ├─ wasm-reference.js   リファレンスページ
        ├─ sample.wasm         サンプル(4.6KB、DWARF 入り)
        └─ sample.c            サンプルのソース
役割分担はこうなっています。
| ファイル | やっていること |
|---|---|
| wasm-core.js | バイナリの解析、命令のデコード、WAT 形式の文字列化、DWARF 行テーブル、機能判定 |
| wasm-opdoc.js | 命令名から「説明」と「スタック効果」をルールで生成 |
| wasm-inspector.js | 3 ペインの描画と連動、ナビゲーション、STATS、ショートカット |
| wasm-reference.js | 全命令の表(wasm-opdoc.js を共用) |
wasm-core.js は DOM に触らないので、Node.js からそのまま import してテストできます。検証は全部この形でやりました。
既存のツールとの違い
作る前に、似たものがあるかを調べました。
| ツール | できること | 形態 |
|---|---|---|
| wabt の公式デモ(wat2wasm / wasm2wat) | WAT ↔ バイナリの変換、wat2wasm 側はその場で実行も可 | Web |
| OmniViewer の WASM Viewer | 全関数の WAT、import / export、セクションのバイトマップ | Web |
| Hexana(JetBrains) | サイズ分析、デッドコード検出、カスタムセクション、DWARF | IDE / VS Code 拡張 |
「WAT を書いてアセンブルして実行する」プレイグラウンドは wabt の公式デモにあり、「中身を WAT で見る」は OmniViewer でできます。同じものを作っても意味がないので、差別化は次の 3 点にしました。
- バイトと命令の双方向連動。命令 1 個が、ファイルのどのバイトに対応するのかまで繋げる
- サイズの内訳と機能判定。どの関数が重いのか、SIMD やスレッドを使っているのか
- DWARF による元ソースの行。命令・バイト・ソース行の 3 つを繋げる
1 をやるために、wabt(wasm2wat)は使わず、パーサーを自前で書くことにしました。wasm2wat の出力はテキストだけで、「この命令はファイルの何バイト目から何バイト目か」を返してくれないからです。
WASM バイナリの構造
.wasm の中身は、思っていたより単純です。
00 61 73 6d   マジックナンバー "\0asm"
01 00 00 00   バージョン 1
[id][size][中身]   セクション
[id][size][中身]   セクション
...
先頭 8 バイトのあとは、セクションが並んでいるだけです。セクションは「ID 1 バイト + サイズ + 中身」の形で、ID ごとに中身の形式が決まっています。
| ID | セクション | 中身 |
|---|---|---|
| 1 | type | 関数の型(引数と戻り値の組み合わせ)の一覧 |
| 2 | import | JS 側に用意してもらう関数・メモリなど |
| 3 | function | 各関数がどの型を使うか |
| 4 | table | 関数参照の表。C の関数ポインタは call_indirect でここを引く |
| 5 | memory | 線形メモリのサイズ(1 ページ = 64KiB) |
| 6 | global | グローバル変数。C のビルドではスタックポインタが入る |
| 7 | export | JS から呼べる関数などの一覧 |
| 9 | element | table の初期値(関数ポインタの並び) |
| 10 | code | 各関数の本体(ローカル変数の宣言と命令列) |
| 11 | data | 線形メモリの初期内容(文字列リテラルや定数テーブル) |
| 0 | custom | 実行には使わない付加情報(関数名、ビルドツール、DWARF など) |
関数の情報が type / function / code の 3 か所に分かれているのが特徴です。「型の一覧」「関数ごとの型番号」「関数の本体」を別々に持つことで、ブラウザは code セクションを読み終わる前に、全関数の型を知ることができます。ダウンロードしながらコンパイルを始める(ストリーミングコンパイル)ための設計です。
LEB128
サイズやインデックスは、ほぼすべて LEB128 という可変長の整数で書かれています。7 ビットずつ下位から並べ、続きがあるバイトは最上位ビットを 1 にします。
624485 = 0x98765
  E5 8E 26
  ↑  ↑  ↑ 最上位ビットが 0 → ここで終わり
  1110_0101 → 下位 7 ビット 0x65
  1000_1110 → 次の 7 ビット 0x0E
  0010_0110 → 次の 7 ビット 0x26
小さい数は 1 バイトで済むので、関数番号やローカル変数番号のように小さい値が大量に出てくる WASM では、ファイルがかなり小さくなります。その代わり、「i32.const 1024」と「i32.const 5」では命令の長さが違います。ステータスバーの op 1 + imm 2 は、この長さを表示しています。
パーサーを自前で書く
JS で LEB128 を読むときはビット演算を使わない
LEB128 の読み方は、C なら result |= (byte & 0x7f) << shift と書くのが普通です。ところが、JS のビット演算子は値を 32 ビット符号付き整数に変換します。2^31 以上の値は負の数になり、シフト量が 31 を超えると結果が壊れます。
そこで、シフトの代わりに掛け算を使いました。
// wasm-core.js(Reader.u32)
u32() {
  let r = 0, m = 1, b;
  do {
    b = this.u8[this.p++];
    r += (b & 0x7f) * m;   // << shift の代わりに × 128^n
    m *= 128;
  } while (b & 0x80);
  return r;
}
JS の数値は 2^53 まで整数を正確に表せるので、u32 の範囲なら問題ありません。i64.const の即値だけは 64 ビットあるので BigInt で読みます。ただし BigInt は遅いので、表示するときにだけ読み、全関数をスキャンするときは読み飛ばしています。
命令は 1 バイトとは限らない
WASM の命令は、基本は 1 バイトのオペコードです。0x00〜0xFF のうち、使われているのは 200 個ほどです。
あとから追加された命令は、プレフィックスの後ろに LEB128 のサブオペコードを付ける形になっています。
| プレフィックス | 内容 | 例 |
|---|---|---|
FC | 飽和変換、バルクメモリ、テーブル操作 | FC 0A = memory.copy |
FD | SIMD(128 ビット) | FD AE 01 = i32x4.add |
FE | スレッド・アトミック | FE 1E = i32.atomic.rmw.add |
i32x4.add のサブオペコードは 0xAE(174)なので、LEB128 で 2 バイト(AE 01)になります。relaxed SIMD はサブオペコードが 0x100 以上なので、FD 85 02 のようにさらに長くなります。
数値演算の 0x45〜0xC4 は、i32 の比較 → i64 の比較 → f32 → f64 → 各型の算術 → 型変換、という規則的な並びです。名前の配列をルールで組み立てて、ちょうど 128 個になることを起動時に確認しています。
if (names.length !== 128) throw new Error('numeric opcode table broken');
names.forEach((n, i) => def(0x45 + i, n));
表を 1 つずらすと全部の命令名がずれるので、こういう確認を入れておくと安心です。
すべての命令にバイト位置を持たせる
デコードした命令は、3 つの位置を持っています。
o.start   // 命令の先頭
o.opEnd   // オペコードの終わり(ここから即値)
o.end     // 命令の終わり
hex で「オペコードは濃く、即値は薄く」光らせているのは、この opEnd です。セクション、import / export の 1 エントリ、data セグメントなども、すべて開始と終了の位置を持たせています。
逆方向、つまり hex のバイトから命令を探すときは、位置の配列を二分探索します。
バイト 0x206 にホバー
  → セクション開始位置の配列を二分探索 → code セクション
  → 関数本体の開始位置の配列を二分探索 → func[6] distance
  → その関数の命令の開始位置を二分探索 → local.get 0
ファイルが大きくても、ホバーのたびに 3 回の二分探索で済みます。
関数は開いたときに初めてデコードする
全関数をあらかじめ WAT にすると、大きなファイルでは数十万行の文字列を作ることになります。そこで、
- 読み込み時:セクションと関数の境界だけを解析
- 関数を開いたとき:その関数の命令の位置だけをデコード
- 画面に描くとき:見えている行だけ文字列化
の 3 段階にしました。開いた関数のデコード結果は、24 個まで LRU でキャッシュしています。
wabt と全命令を突き合わせる
逆アセンブラは、1 か所でも即値の長さを読み間違えると、そこから先が全部ずれます。そこで、wabt(wasm2wat)の出力と比較しました。
| 比較対象 | 結果 |
|---|---|
| tree-sitter.wasm(200KB、277 関数)の全命令の並び | 89,869 命令すべて一致 |
| 即値(memarg、定数など)を含めた表記 | 72,645 命令中、差は浮動小数点の表記 17 件のみ |
| プレフィックス命令(FC / FD / FE)全 341 個の名前 | すべて一致 |
浮動小数点の差は、wabt が 0x1p+4 のような 16 進の浮動小数点表記で出すのに対して、こちらは 16 と 10 進で出しているだけで、値は同じです。
プレフィックス命令の確認は、全オペコードを 1 個ずつ並べた関数を持つ .wasm をテスト用に組み立て、wabt に逆アセンブルさせて名前を比べる、という方法でやっています。
解析とスキャンの速さは、tree-sitter.wasm で 21ms でした。
3 ペインの連動
Canvas の仮想スクロール
WAT と hex は、どちらも Canvas に描いています。DOM の要素で数十万行を作ると重いので、見えている行だけを毎回描きます。スクロールバーも自前です。
draw() {
  const n = Math.min(this.count() - this.top, this.vis() + 1);   // 見えている行数
  this.o.draw(ctx, this.top, n, this.w);
}
libarchive.wasm(979KB、1,167 関数、34 万命令)でも引っかかりなく動きます。
hex は、パネルの幅に合わせて 1 行 16 バイトと 8 バイトを自動で切り替えます。
バイトの色
hex の文字色は、そのバイトが属するセクションの色です。code セクションの中は、関数ごとに明暗を交互にしています。隣り合う関数の境目が、hex のままでも見えるようにするためです。
セクションの先頭(ID とサイズ)は白、custom セクションの名前部分は明るい灰色にしています。
読みやすくするための表示
WAT をそのまま出すと、call 42 や i32.const 1036 のような数字ばかりになります。そこで、分かる範囲で名前に置き換えています。
- 関数名:name セクションにあればそれを、なければ import / export の名前を使う
- データの文字列:
i32.constの値が data セグメントの中を指していたら、そこにある文字列を横に出す
i32.const 1036 ;; "PROTOCOL.LAIN"
i32.const 13
call $log_str
data セグメントの配置先アドレス((i32.const 1024) のような定数式)を集めておき、i32.const の値がその範囲に入っていれば、その位置から印字できる文字が 3 文字以上続くかを調べています。文字列でなければ data[0]+0x1c のように位置だけを出します。C の文字列リテラルがどこに置かれ、どの命令から参照されているかが、これで追えるようになります。
クリックで固定する
WAT の行をクリックすると、ステータスバーの内容がその行で固定されます。ホバーが外れると、固定した内容に戻ります。
最初はホバーしている間しか表示していなかったので、ステータスバーのリンク(命令リファレンスへの REF↗)を押しに行くと、マウスが WAT から離れた瞬間に表示が消えていました。
STATS と機能判定
STATS タブでは、ファイルの「重さの内訳」を見られます。
- セクション別のサイズ
- 大きい関数の上位 30
- オペコードの出現頻度の上位 30
- import をモジュール名ごとに集計
機能判定は、全関数の命令をスキャンして、実際に使われているオペコードから決めています。
| 機能 | 判定の根拠 |
|---|---|
| SIMD | FD プレフィックスの命令がある |
| Threads / Atomics | FE プレフィックスの命令がある、または shared memory |
| Bulk Memory | memory.copy / memory.fill など |
| Sign Extension | i32.extend8_s など(0xC0〜0xC4) |
| Multi-Value | 戻り値が 2 つ以上の型がある、またはブロックの型がインデックス指定 |
| Tail Call | return_call |
| Exceptions | try / catch(旧仕様)、try_table(exnref 版) |
| Memory64 / Multi-Memory | memory の宣言を見る |
target_features というカスタムセクションに、ビルド時に有効だった機能が書かれていることもあります。ただ、これは「有効にしていた」というだけで、「実際に使った」とは限りません。サンプルの target_features には +mutable-globals と +sign-ext が書かれていますが、命令のスキャンではどちらも使われていませんでした。
スキャンは 14ms ごとに区切って setTimeout で画面に処理を返しながら進めるので、大きなファイルでも読み込み直後から操作できます。
v1.1:DWARF で元のソース行を出す
ここからが v1.1 です。
DWARF とは
-g 付きでビルドすると、.wasm に .debug_info や .debug_line といったカスタムセクションが追加されます。中身は DWARF というデバッグ情報の形式で、ネイティブの ELF などと同じものです。
| セクション | 中身 |
|---|---|
.debug_line | 命令のアドレス → ソースのファイル・行・列 の対応表 |
.debug_info | 関数・変数・型の情報 |
.debug_abbrev | .debug_info を読むための略記表 |
.debug_str | 文字列 |
.debug_loc / .debug_ranges | 変数の場所、アドレス範囲 |
今回読んだのは .debug_line だけです。WAT の命令に元のソース行を対応させるには、これで足ります。
行テーブルは「状態機械のプログラム」
.debug_line には、「アドレス → 行」の表がそのまま入っているわけではありません。表を作るための小さなプログラム(命令列)が入っています。
サンプルの先頭部分を llvm-dwarfdump --debug-line --verbose で見ると、こうなっています。
状態: addr = 0, file = 1, line = 1, column = 0

00 DW_LNE_set_address (0x2)   addr = 0x2
03 DW_LNS_advance_line (29)   line += 28 → 29 行目
01 DW_LNS_copy                この状態を 1 行として表に出す → (0x2, 29 行目)
05 DW_LNS_set_column (9)      column = 9
08 DW_LNS_const_add_pc        addr += 0x11
83                            特殊オペコード: addr += 8, line += 1 → (0x1b, 30 行目)
...
DW_LNE_end_sequence           ここで終わり
よく使う「アドレスを少し進めて、行を少し進めて、1 行出す」は、特殊オペコードという 1 バイトの命令にまとめられています。オペコードの値からアドレスと行の増分を計算する方式です。
// wasm-core.js(parseDwarfLines の一部)
if (op >= opcodeBase) {
  const adj = op - opcodeBase;
  addr += Math.floor(adj / lineRange) * minInst;
  line += lineBase + (adj % lineRange);
  emit(false);
}
LEB128 と同じで、よく出てくるパターンほど短く書けるように工夫されています。
WASM の DWARF ならではの点
WASM 版の DWARF には、ネイティブとは違う決まりがあります。
1. アドレスは「code セクションの中身の先頭」からのオフセット
ネイティブでは、アドレスはメモリ上の番地です。WASM には命令のアドレスという概念がないので、code セクションの中身の先頭を 0 として数えます。ファイル上の位置に直すには、code セクションの開始位置を足します。
out.addr[i] = codeBase + row.addr; // codeBase = code セクションの中身の先頭2. 削除された関数は「墓石アドレス」になる
リンク時に使われなかった関数の行情報は、アドレスが 0xFFFFFFFF(ツールによっては 0)に書き換えられて残っています。これを読むと、存在しない位置に行が割り当てられるので、捨てています。
3. DWARF 4 と 5 でヘッダーの形式が違う
DWARF 5 では、ディレクトリとファイル名の一覧が「形式の指定 + 中身」という可変の形になり、文字列も別のセクション(.debug_line_str)を参照するようになりました。clang 18 の既定は DWARF 4 ですが、-gdwarf-5 を付けると 5 になるので、両方に対応しています。
llvm-dwarfdump と突き合わせる
検証は、LLVM の llvm-dwarfdump --debug-line の出力と比べました。サンプルを DWARF 4 と 5 の両方でビルドして、どちらも 124 行が完全に一致しています。
表示は objdump -S 方式
ソースの行が変わるところに、元のソース行を挟んでいます。objdump -S と同じ見せ方です。
(func $fib (;2;) (export "fib") (type 0) (param i32) (result i32)
  (local i32)
  ;; sample.c:29  │ int fib(int n) {
  i32.const 0
  local.set 1
  ...
      i32.const 2
      ;; sample.c:30  │ if (n < 2) return n;
      i32.lt_s
      br_if 1
      ...
      ;; sample.c:31  │ return fib(n - 1) + fib(n - 2);
      i32.add
      call $fib
i32.const 2 が 29 行目の側に入っているのは、表示の間違いではありません。行テーブルの 30 行目は 9 列目、つまり n < 2 の < の位置から始まっています。clang は比較の命令(i32.lt_s)に 30 行目を割り当てていて、その手前で値を積む命令は前の行の続きとして扱われている、という割り振りです。DWARF の行は「この命令から、この行の処理が始まる」という区切りなので、1 行の処理の一部が前の行に入って見えることがあります。
DWARF に入っているのはファイル名と行番号だけで、ソースの中身は入っていません。行の中身まで表示するには、.wasm を読み込んだ後にソースファイルをドロップします(一緒に選んでも構いません)。ファイル名で照合しています。
ソースの行は SRC ボタンか S キーで消せます。消したり出したりすると WAT の行番号がずれるので、「戻る」の履歴は行番号ではなくバイト位置で持つようにしました。
サンプルを C で作る
最初は読めなかった
ツールが動いた後、試しに Archive Manager で使っている libarchive.wasm(979KB)を読み込んでみました。STATS で分かったことはこうです。
- 関数 1,167 個、命令 34 万個
- code が 69.5%、data が 30.2%
- 使っている機能は Sign Extension だけ(SIMD もスレッドもない素のビルド)
ところが、WAT の方は読めませんでした。リリースビルドなので name セクションが削られていて、1,167 個の関数がすべて (no name) です。関数一覧に 38 K や 1104 F と出ているのは、ビルド時の最適化で export 名が 1 文字に縮められたものです。番号しか手がかりがない状態で中身を読むのは、もうリバースエンジニアリングです。
紹介ページで見せるなら、関数名が残っていて、DWARF も入っている小さなサンプルが必要です。手書きの WAT ではなく、C を実際のコンパイラでビルドしたものにしました。その方が、コンパイラが実際にどういうコードを出すのかが見えるからです。
ビルド
Emscripten は使わず、clang だけでビルドしています。標準ライブラリを使わない C なら、これで .wasm が出ます。
clang --target=wasm32 -O1 -g -ffile-prefix-map=$PWD=. \
      -nostdlib -Wl,--no-entry -Wl,--export-dynamic -Wl,--import-undefined \
-o sample.wasm sample.c| オプション | 意味 |
|---|---|
--target=wasm32 | WASM 向けにコンパイル |
-O1 | 軽い最適化(後述の観察はこれの結果) |
-g | DWARF を出す |
-ffile-prefix-map=$PWD=. | DWARF に入る絶対パスを . に置き換える |
-nostdlib -Wl,--no-entry | libc なし、main なし |
-Wl,--import-undefined | 定義のない関数(log など)を import にする |
-ffile-prefix-map は付け忘れやすいので注意です。付けないと、DWARF にビルドしたマシンの絶対パス(/home/ユーザー名/...)がそのまま入り、公開したファイルから誰でも読めてしまいます。
C 側では、属性で export と import の名前を指定しています。
#define EXPORT(name) __attribute__((export_name(name)))
#define IMPORT(name) __attribute__((import_module("env"), import_name(name)))

IMPORT("log") void log_i32(int value);

EXPORT("fib")
int fib(int n) { ... }
サンプルには、再帰、ループ、文字列、64 ビット整数、浮動小数点、構造体の配列、関数ポインタ、switch を入れて、WASM の主要なセクションと命令が一通り出てくるようにしました。
できあがった sample.wasm は 4,697 バイトです。そのうち DWARF の 6 セクションが 3.5KB、命令の入った code セクションは 589 バイトでした。中身の 4 分の 3 がデバッグ情報です。
見つけたこと 1:main の中身がほぼ定数になっていた
main はこう書きました。
int main_entry(void) {
  int f = fib(10);
  log_i32(f);
  log_str(TITLE, str_len(TITLE));
  log_i32((int)fnv1a(MOTTO, str_len(MOTTO)));
  log_i32(sum_weights());
  log_i32(apply_layer(1, 7));
  log_i32(describe_layer(3, f));
  return f;
}
WAT を見ると、こうなっていました。
i32.const 10
call $fib
local.tee 0
call $log_i32
i32.const 1036 ;; "PROTOCOL.LAIN"
i32.const 13              ;; str_len(TITLE) → 13
call $log_str
i32.const -1500192074     ;; fnv1a(MOTTO, str_len(MOTTO)) → 定数
call $log_i32
i32.const 260             ;; sum_weights() → 260
call $log_i32
i32.const 49              ;; apply_layer(1, 7) → 49
call $log_i32
local.get 0               ;; describe_layer(3, f) → 中身が展開された
call $log_i32
local.get 0
i32.const -1
i32.add
call $log_i32
関数呼び出しが、ほとんど消えています。
str_len(TITLE):文字列が定数なので、長さ 13 がコンパイル時に決まるfnv1a(...):ハッシュ計算のループごと、コンパイル時に実行されて答えだけが残るsum_weights():構造体の配列の合計 260apply_layer(1, 7):関数ポインタの表からlayer_squareを引いて7 * 7を計算した、49describe_layer(3, f):switch のcase 3の中身(log_i32(value); return value - 1;)だけが展開された
関数ポインタ経由の呼び出しまで畳まれているのは意外でした。表が static で書き換えられないことが分かっているので、layers[1] が layer_square だと確定できるわけです。
fib(10) だけは残っています。再帰の深さが決まらないので、コンパイル時には計算しません。
見つけたこと 2:switch が br_table にならなかった
最初は、switch のサンプルとして「層番号から文字数を返す」関数を書きました。
switch (layer) {
  case 0: return 4;
  case 1: return 9;
  ...
  case 7: return 13;
  default: return -1;
}
これを WAT で見ると、br_table ではありませんでした。
local.get 0
i32.const 2
i32.shl              ;; layer * 4
i32.const 1052 ;; data[0]+0x1c
i32.add
i32.load             ;; メモリ上の表から値を読む
各 case が定数を返すだけなので、clang は「分岐」ではなく「定数の表を引く」コードに変えていました。表は data セグメントに入っています。
そこで、case ごとに違う処理(関数呼び出し、掛け算、シフトなど)をするように書き直したら、やっと br_table になりました。
block
  block
    ...(9 段)
          local.get 0
          br_table 0 1 2 3 7 4 5 6 8
        end
        ;; sample.c:111  │ case 0: log_str(TITLE, 13); return value;
block が 9 段入れ子になり、br_table の値で何段抜けるかを選ぶ形です。WASM には goto がないので、switch は「入れ子のブロックから何段抜けるか」で表現されます。case 4 は呼び出しが定数に畳まれて他と処理がまとめられたので、並び順が 3 7 4 と飛んでいます。
見つけたこと 3:再帰の片方がループになった
fib は、return fib(n - 1) + fib(n - 2); の再帰で書きました。WAT を見ると、call $fib は 1 回しかありません。
loop
  ...
  local.get 0
  i32.const -1
  i32.add
  call $fib          ;; fib(n - 1) は再帰のまま
  i32.add            ;; 結果をアキュムレータに足す
  local.set 1
  local.get 0
  i32.const -2
  i32.add
  local.set 0        ;; n = n - 2 にして
  br 0               ;; ループの先頭へ(fib(n - 2) の代わり)
end
fib(n - 2) の方は、「n を 2 減らしてループを回す」に変わっています。末尾の再帰をループに変えて、足し算はアキュムレータ(ローカル変数 1)に貯める形です。WAT の間にソース行が挟まっていると、どの命令がどの式から来たのかが追えるので、こういう変形がよく分かります。
ソース行の並びも面白いことになっています。ループの中は 30 行目 → 31 行目と進み、ループの end で再び 30 行目に戻ります。ループの先頭に戻ったら、また if (n < 2) の判定から始まるからです。冒頭で紹介した Qiita の記事にあった「ステップ実行で行番号が反復横跳びする」の、最適化版の実例です。
C で書いて最適化付きでビルドしたことで、手書きの WAT では出てこない「コンパイラの癖」が見られるサンプルになりました。
命令の意味とリファレンス
540 命令の説明をルールで作る
WAT に慣れていない人には、i64.extend_i32_u や i8x16.narrow_i16x8_s が何をするのか分かりません。そこで、命令ごとに「スタック効果」と「説明」を付けました。
i32.add [i32 i32] → [i32] 2 つ取り出して和(a + b)を積むWASM はスタックマシンなので、「何を取り出して、何を積むか」が分かれば、命令の働きはだいたい分かります。
540 個を 1 つずつ手で書くのは大変なので、命令名のパターンから生成しています。
// wasm-opdoc.js(scalar の一部)
const m = name.match(/^(i32|i64|f32|f64)\.(.+)$/);
const [, t, op] = m;
if (BIN[op]) return d(`[${t} ${t}] → [${t}]`, `2 つ取り出して${BIN[op]}を積む`);
if (CMP[op]) return d(`[${t} ${t}] → [i32]`, `2 つ取り出して ${CMP[op]} なら 1、そうでなければ 0 を積む`);
i32.add も f64.add も i32x4.add(SIMD)も、「型 + 演算名」の組み合わせです。演算名ごとの説明(add → 和、lt_u → 符号なしの a < b、など)と、型ごとの組み立て方を書いておけば、大半の命令はそこから作れます。制御命令のような規則に乗らないものだけを、個別に書きました。
全命令に説明が付いていることは、Node.js で全オペコードを回して確認しています(不足 0 件)。
ステータスバーに出す
命令の説明は、ポップアップではなくステータスバーに 1 行出すだけにしています。
br_table [i32] → 戻らない  インデックスで分岐先を表から選ぶ(switch 文)。範囲外なら最後の既定ラベルへ  REF↗
SRC sample.c:110:3  switch (layer) {
このツールを使う人は、普段から大量のマニュアルを読んでいる人です。マウスの移動でポップアップが出るのは邪魔になります。IDE のホバードキュメントと同じで、見たいときに視線を下にやれば読める、くらいの距離にしました。
リファレンスページ
全命令の一覧は、別ページ(/wasm-inspector-reference)に分けました。オペコードのバイト列・即値・スタック効果・説明を表にして、検索とグループでの絞り込みができます。「ゼロ拡張」で検索すると、ゼロ拡張する命令が 22 個出てきます。
ステータスバーの REF↗ から、/wasm-inspector-reference#i32.load8_u のようなハッシュ付きのリンクで、その命令の行に飛べます。
HELP とショートカット
画面だけでは分からない操作(ダブルクリックで呼び出し先へ、hex のクリックでジャンプ、など)は、? HELP ボタンか ? キーで開くダイアログにまとめました。最初に自動で開くことはありません。
| キー | 操作 |
|---|---|
? | ヘルプ |
G | GOTO 欄へ(0x1a2b でオフセット、#12 で関数番号、$main で関数名) |
/ | 関数検索 |
[ ] | 前 / 次の関数 |
Backspace / Alt+← | 戻る |
T | WAT と STATS の切り替え |
S | ソース行の表示の切り替え |
L | 左パネルの表示の切り替え |
Esc | 選択の解除 / 入力欄から抜ける |
入力欄にフォーカスがあるときは、ショートカットを無効にしています。関数名の検索で s を打つたびにソース表示が切り替わったら困るからです。
ハマりどころ
1. Astro で CSS が古いまま残る(また)
#157、#158 に続いて、今回も当たりました。HELP ダイアログを足したら、ダイアログがブラウザ標準の白い背景で全画面に出て、GOTO 欄も標準の入力欄の見た目になっていました。マークアップは新しいのに、今回足したスタイルだけが効いていない状態です。
DevTools のコンソールに、Vite の HMR の WebSocket(wss://localhost:4321/...)の接続失敗が出ていました。開発サーバーとブラウザの間の更新通知が切れていて、.astro の <style> の差し替えが届いていなかったようです。JS は再読み込みで新しくなるので、「HTML と JS は新しいのに CSS だけ古い」という状態になります。
切り分けのために、Astro で実際にビルドして同じ構成で表示したところ、ビルド後の CSS にはスタイルが全部入っていて、表示も正しく出ました。開発サーバーの再起動で直っています。.astro のスタイルを触ったら再起動、をもう手順にしてしまった方がよさそうです。
2. ハッシュ付きのリンクで目的の行に飛ばない
リファレンスページで、#i32.load8_u のリンクを開くと、その行がヘッダーの裏に隠れていました。JS では行を画面の中央にスクロールしていたのに、です。
原因は、行の要素の id をハッシュと同じ i32.load8_u にしていたことでした。ブラウザは、ページを開くとハッシュと同じ id の要素を画面の一番上に合わせる、という標準の動作をします。これが自分のスクロール処理の後に走って、上書きしていました。一番上に合わせると、固定ヘッダーの裏に入ってしまいます。
id を op-i32.load8_u のように接頭辞付きにして、ブラウザ側の動作が起きないようにしました。
3. ファイル選択で複数のファイルを選べなかった
.wasm とソースファイルを一緒に選べるようにしたつもりが、ファイル選択のダイアログでは 1 つしか選べませんでした。<input type="file"> に multiple を付け忘れていて、accept=".wasm" も残っていたので、.c は選択肢にすら出ていませんでした。ドラッグ&ドロップでは複数のファイルを落とせるので、そちらでは気づきませんでした。
Playwright でテストを書いて、setInputFiles に 2 つのファイルを渡したら、「Non-multiple file input can only accept single file」で落ちて気づいています。
4. ホーム画面の小さいウインドウで WAT が潰れる
ホーム画面のウインドウ(iframe)で開くと、WAT の列が 270px くらいまで潰れていました。左パネル 270px と hex 580px を固定幅にしていたので、狭くなると真ん中だけが縮むわけです。
hex は幅が足りないと 1 行 8 バイトに切り替わる仕組みをもともと持っていたので、メディアクエリで両側の幅を段階的に縮めるだけで済みました。
| 画面幅 | 左パネル | hex | WAT(実測) |
|---|---|---|---|
| 1500px 以上 | 270px | 580px(16 バイト / 行) | 1600px で 748px |
| 〜1200px | 210px | 330px(8 バイト / 行) | 1124px で 582px |
| 〜900px | 隠す(L キーで重ねて表示) | 330px | 800px で 469px |
900px 以下では左パネルを隠しますが、それだと最初にファイルを開くボタンも見えなくなります。何も読み込んでいないときだけは、左パネルを重ねて表示しておくようにしました。
埋め込みモードで余白を消す BaseLayout のルールは .app を対象にしているので、今回のコンテナも class="app" にしています(#158 と同じ)。
クレジットとライセンス
実行時に使っている外部ライブラリはありません。パーサー、逆アセンブラ、DWARF の行テーブルの読み込み、画面はすべて自作です。
検証には次のツールを使いました(ページには含まれていません)。
- WABT(Apache License 2.0)— wasm2wat の出力との比較、サンプルの検証 github.com/WebAssembly/wabt
- LLVM / clang 18(Apache License 2.0 with LLVM Exception)— サンプルのビルド、
llvm-dwarfdumpとの比較 llvm.org
GitHub - WebAssembly/wabt: The WebAssembly Binary Toolkit
The WebAssembly Binary Toolkit
github.com命令の仕様は WebAssembly Core Specification、DWARF の行テーブルは DWARF Debugging Information Format(Version 4 / 5)を参照しています。
おわりに
#157 は TrueType 命令を読み下す側、#158 はソースコードを木にする側、今回はコンパイラが出したバイトコードを読み下す側でした。
実際にやってみると、WASM のバイナリは思っていたより素直な形式でした。セクションが並んでいるだけで、LEB128 さえ読めれば、あとは仕様書の表のとおりに読み進めれば済みます。一番手間がかかったのは、読むことよりも「読んだものを、元のバイトにどう繋ぎ直すか」の方でした。
一番面白かったのは、C で書いたサンプルの WAT でした。関数呼び出しが定数に化け、switch が表引きに化け、再帰がループに化けていました。WAT の間にソース行が挟まっていると、「この 1 行がこう変わった」が直接見えます。CS 講座でコンパイラの最適化を説明するときの教材になりそうです。
次にやるとしたら、DWARF の .debug_info を読んで、WAT のローカル変数を C の変数名に置き換えるところです。local.get 0 が n だと分かるだけでも読みやすくなりますし、fib のアキュムレータ(ローカル変数 1)のように C のどの変数にも対応しない「コンパイラが作った変数」が区別できると、最適化の跡がもっと見えるはずです。