[Astro] #170 Subtitle Converter — SRT / VTT / ASS / SBV / LRC の変換とズレ補正(SJIS対応)
はじめに
前回は、PSD / PSB ビューアの作り直しでした。
[Astro] #169 PSD / PSB Viewer — レイヤー一覧ビューアを、自前パーサーで合成・マスク・書き出しまで作り直し、1GB超の PSB を開く
PSD / PSB ビューアを作り直しました。
lain-lab.com今回は、プロジェクトマップの「未開拓アイデア」にあった、Subtitle Converter です。データ / ファイル操作のツールの中で、テキスト系の形式だけが、手薄でした。
作った日は、利用枠が残り 6% ほどしかありませんでした。そこで、重いものは避けて、いちばん軽そうなものを選びました。自前のパーサーだけで、WASM もライブラリも要らないからです。ここまでの利用枠の消費は、約 1% でした。
軽いぶん、機能は多めにしました。今回の要点は、次の 6 つです。
- 5 つの形式を、「開始・終了・本文」の形にそろえて、相互に変換する
- 文字コードを自動で判定し、Shift_JIS でも書き出す
- ズレの種類ごとに、直し方を分ける(ずらし、FPS、2 点指定、動画に合わせる)
- 動画や音声を読み込んで、字幕を重ねて確認する
- 整形(タグ、効果音、重複、重なり、短すぎる字幕)をまとめて直す
- 使い方は、ヘルプのダイアログに入れて、サンプルも付ける
完成画面
サンプルを読み込んだところ
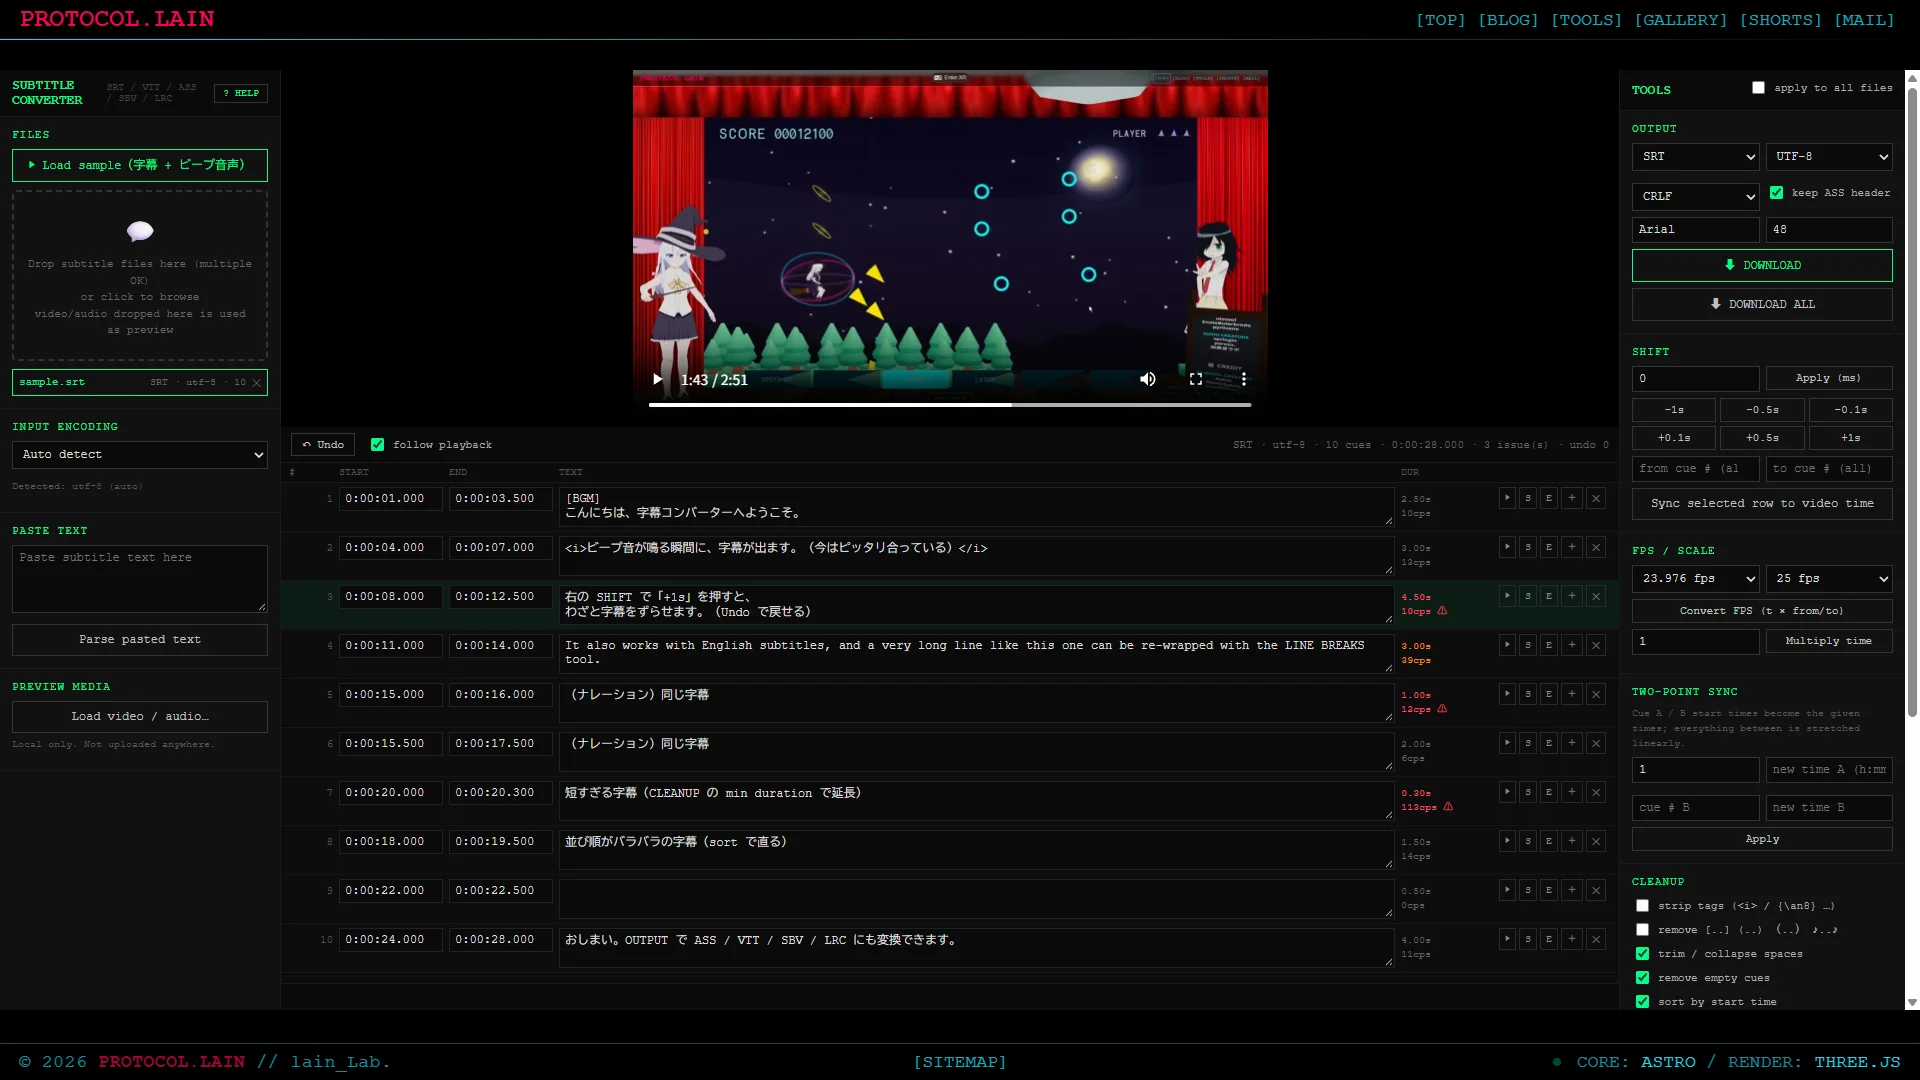
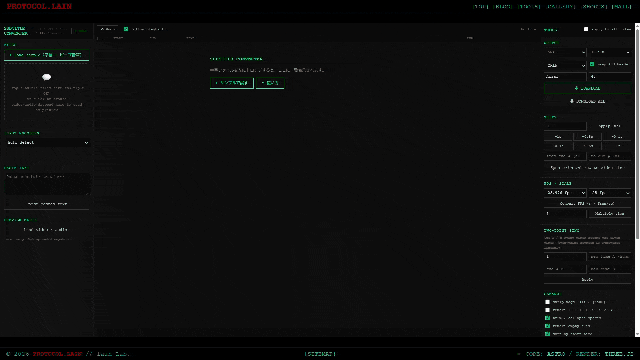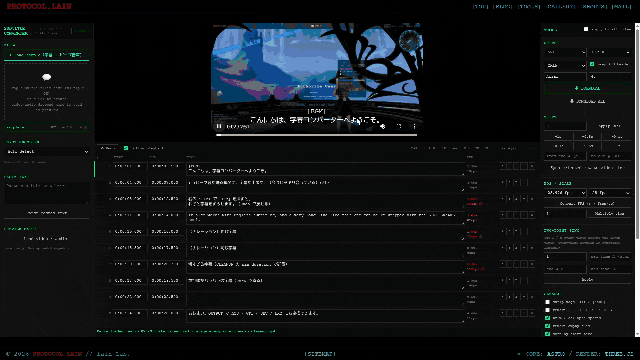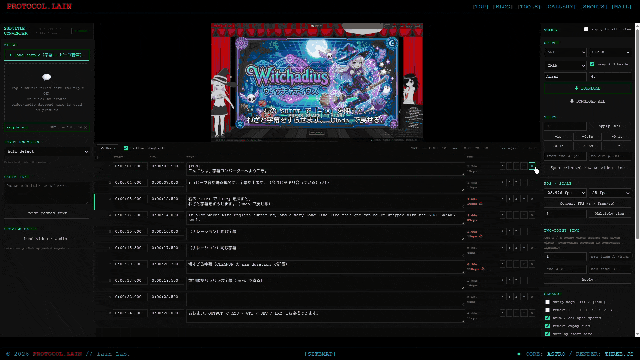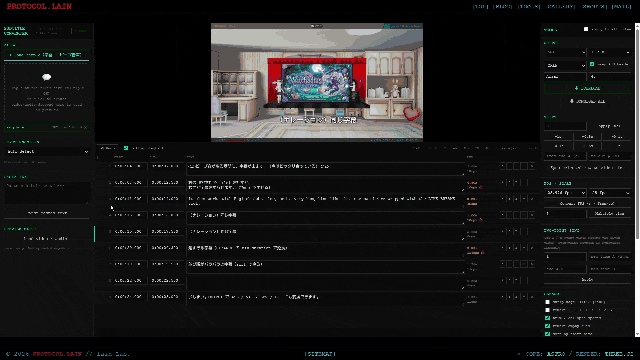
左がファイルと文字コード、中央が字幕の一覧とプレビュー、右が補正と書き出しのツールです。一覧は、時刻も本文も、その場で書き換えられます。赤い ⚠ は、終了が開始より前か、次の字幕と時間が重なっている行です。サンプルでは、3 件が出ます。
ヘルプのダイアログ
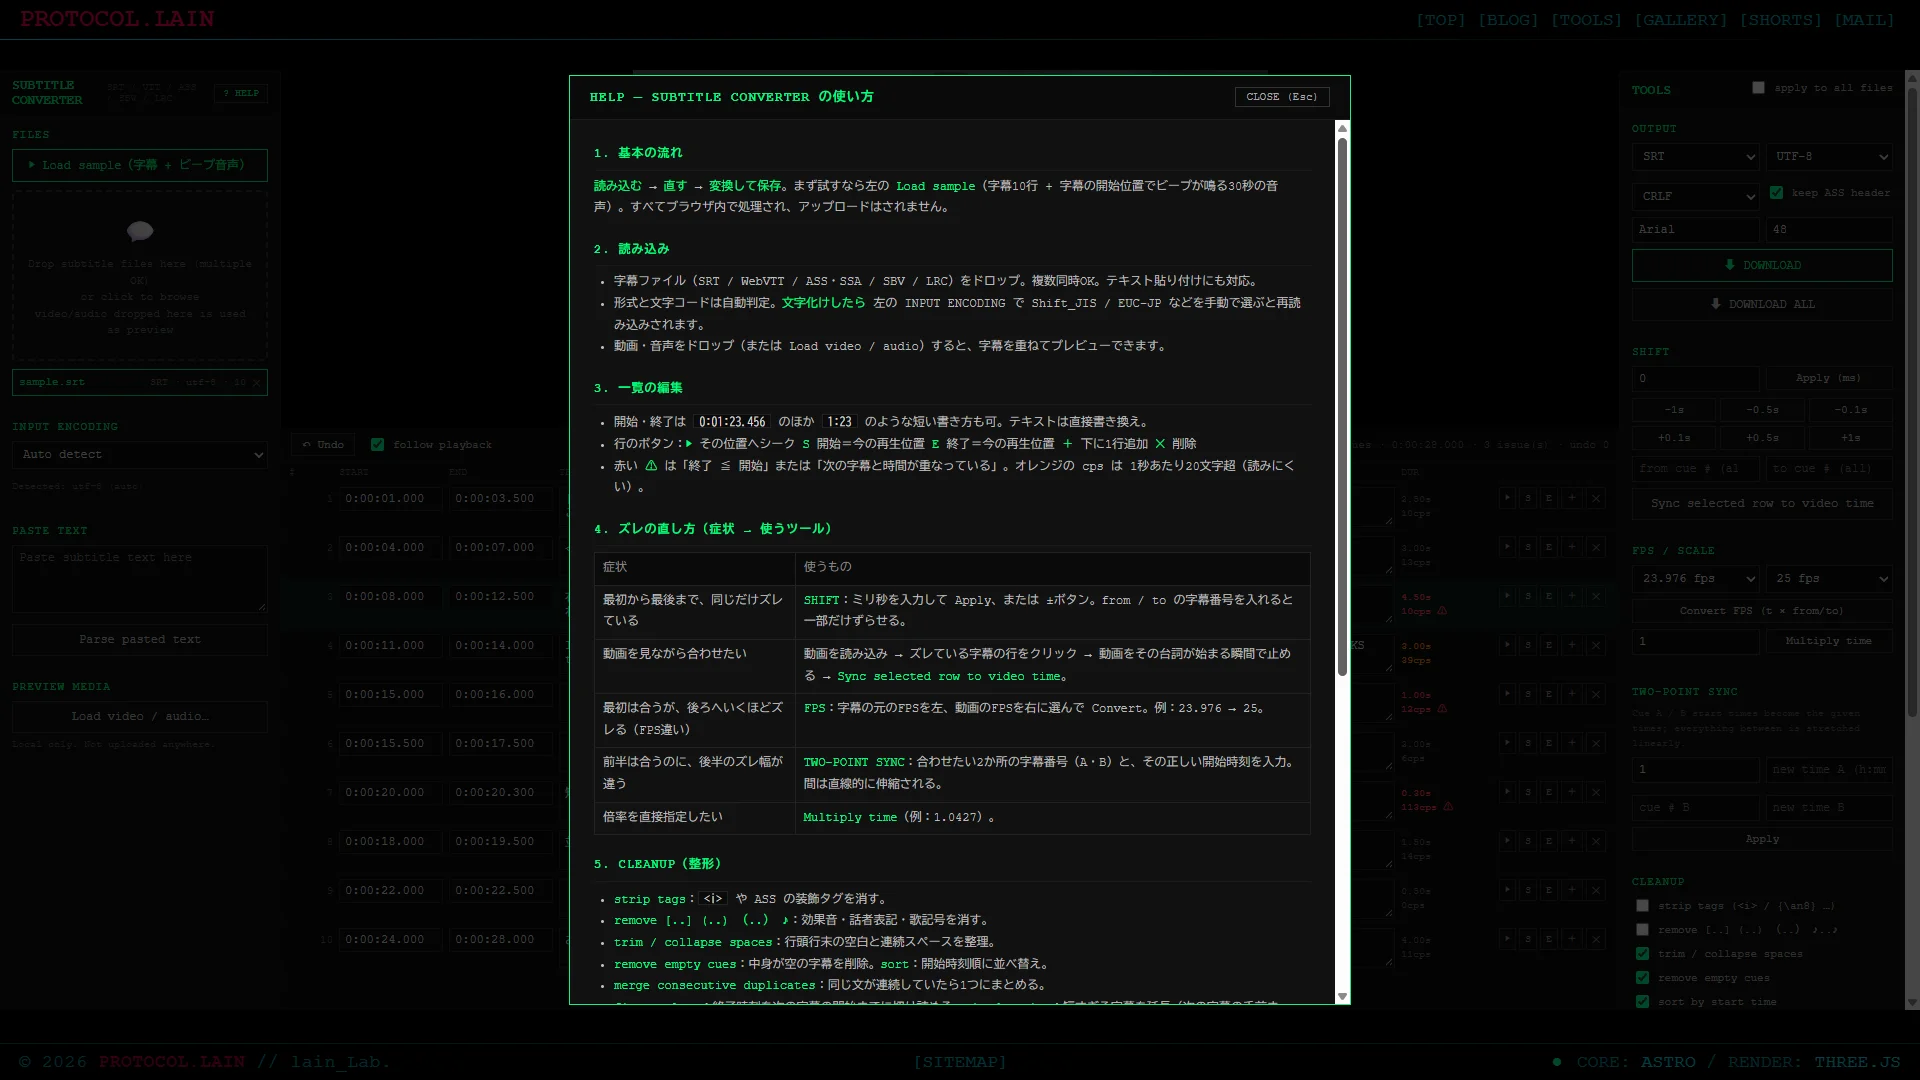
最初は、使い方を左のパネルに、そのまま書いていました。メインの画面には、うるさかったので、ヘッダーの「? HELP」から開くダイアログに移しました。
動画
5 つの形式を、同じ形にそろえる
形式ごとに、時刻の書き方が違います。
| 形式 | 時刻の例 | 特徴 |
|---|---|---|
| SRT | 00:01:02,500 | 番号、時刻の行、本文。空行で区切る |
| WebVTT | 00:01:02.500 | 先頭に WEBVTT。時間が mm:ss.mmm だけの書き方もある |
| ASS | 0:01:02.50 | 1/100 秒。スタイルや位置を持つ |
| SBV | 0:01:02.500,0:01:05.000 | 開始と終了を、カンマで 1 行に書く |
| LRC | [01:02.50] | 開始だけ。終了を持たない |
読み込んだら、全部、次の形にします。時刻は、ミリ秒の整数です。
{ s: 1500, e: 3000, text: '本文', style?: 'Default', ... }時刻は、1 つの正規表現で読む
SRT と VTT と ASS で、時刻を読むところを、共通にしました。時間は省けて、小数部は、1〜3 桁なら読めます。
const TIME_RE = /(?:(\d+):)?(\d{1,2}):(\d{1,2})(?:[.,:](\d{1,3}))?/;
// 小数部は 3 桁にそろえる("5" も "50" も "500" も 500 ミリ秒)
const fr = m[4] ? Number((m[4] + '00').slice(0, 3)) : 0;一覧に打ち込む時刻にも、同じ関数を使っています。そのため、1:23 のような短い書き方も通ります。
形式の判定
拡張子より先に、中身で判定します。WEBVTT で始まれば VTT、[Script Info] や Dialogue: があれば ASS、--> があれば SRT か VTT(小数点がカンマかピリオドかで分ける)、というふうに見ていきます。拡張子は、最後の手がかりです。貼り付けたテキストにも、同じ判定が使えます。
ASS の読み方
ASS は、Format: の行で列の並びが決まっています。Dialogue: の行を、列の数だけカンマで区切ります。ただし、本文にはカンマが入るので、最後の列には、残りを全部入れます。
読み込むときに、[Events] より前の部分(スタイルの定義など)を、そのまま取っておきます。ASS から ASS に書き出すときは、これを使うので、元のスタイルが保たれます。
本文のタグは、変換して書き出す
本文のタグは、読み込んだ形のまま持っておいて、書き出すときに変換します。
- ASS → SRT / VTT:
{\i1}を<i>に直す(斜体・太字・下線だけ)。残りの{...}は消す - SRT / VTT → ASS:
<i>を{\i1}に直す。ほかのタグは消す - SBV / LRC:タグは、すべて消す
ASS の位置指定(\an8 など)は、SRT や VTT に出すときに、消えます。
LRC は、終了を作る
LRC には、終了時刻がありません。次の行の開始を、前の行の終了にしています。最後の行だけは、開始の 3 秒後にしました。この 3 秒は、私が決めた値で、仕様ではありません。
文字コードを、判定する
日本語の字幕は、Shift_JIS のものが、今でもあります。UTF-8 と決めつけると、文字化けします。判定の順番は、次のとおりです。
- BOM があれば、それに従う(UTF-8、UTF-16 LE、UTF-16 BE)
- BOM がなくても、先頭の 4000 バイトに、
0x00が多ければ、UTF-16 とみなす(偶数番目か奇数番目かで、LE と BE を分ける) - UTF-8 として、厳密に読めれば(
fatal: true)、UTF-8 - それ以外は、Shift_JIS、EUC-JP、GBK、Big5、EUC-KR で、それぞれ読んでみて、点数をつけて、いちばん高いものにする
4 つ目の点数は、次のように付けています。
- 読めない文字(
U+FFFD)は、大きく減点する - ひらがなとカタカナは、日本語の文字コードのときだけ、加点する
- 漢字は、少し加点する
- 半角カタカナは、減点する(EUC-JP の文字を Shift_JIS で読むと、半角カタカナだらけになるため)
どれも、決め打ちの重みで、理論があるわけではありません。
短い文で外れた
テストで、1 つだけ、外れました。「こんにちは、世界。アイウ〜」のような、短くて、半角カタカナが入った文を、Shift_JIS で保存して読ませたところ、GBK と判定されました。半角カタカナの減点が、Shift_JIS には重すぎました。Shift_JIS のときだけ、減点を半分にして、直しました。
短い文は、判定の材料が少ないので、外れやすいです。そのため、左のパネルに、文字コードを手で選ぶ欄を置いてあります。選び直すと、同じバッファから読み直します。
Shift_JIS で書き出す
古いプレーヤーや機器では、UTF-8 の字幕が読めないことがあります。そこで、Shift_JIS でも書き出せるようにしました。
ブラウザの TextEncoder は、UTF-8 しか書けません。そこで、TextDecoder('shift_jis') の方を使って、逆引きの表を作りました。2 バイトの組み合わせを、全部、読ませて、1 文字になったものを、表に入れていきます。
const d = new TextDecoder('shift_jis');
// 上位バイト 0x81〜0x9F, 0xE0〜0xFC / 下位バイト 0x40〜0xFC(抜粋)
for (let l = 0x81; l <= 0xFC; l++) {
  if (l >= 0xA0 && l <= 0xDF) continue;
  for (let t = 0x40; t <= 0xFC; t++) {
    const s = d.decode(new Uint8Array([l, t]));
    if (s.length === 1 && s !== '�' && !SJ.has(s)) SJ.set(s, [l, t]);
  }
}
表は、最初に使うときだけ作ります。ブラウザの Shift_JIS は、実質、Windows の CP932 です。
文字の対応を、少し直す
Unicode と CP932 で、同じ文字が、別の番号になるものがあります。「〜」(U+301C)は、CP932 では「~」(U+FF5E)です。このような 5 つの文字だけ、書き出す前に置き換えます。
U+301C(〜)→U+FF5EU+2212(−)→U+FF0DU+2016(‖)→U+2225U+2014(—)→U+2015U+00A6(¦)→U+FFE4
表にない文字は、? にして、何文字あったかを、画面の下に出します。
ズレを直す
字幕のズレには、種類があります。それぞれに、使うものを分けました。
| 症状 | 使うもの |
|---|---|
| 最初から最後まで、同じだけズレる | SHIFT(ミリ秒。一部の範囲だけも可) |
| 動画を見ながら合わせたい | 動画を読み込んで、行をクリックして、再生位置に合わせる |
| 後ろにいくほどズレる(FPS 違い) | FPS の変換 |
| 前半は合うが、後半のズレ幅が違う | 2 点指定 |
FPS の変換と、2 点指定は、同じ式
FPS の変換も、2 点指定も、中身は、時間の 1 次式です。
// 新しい時刻 = t1 + (今の時刻 - s1) × k
const linear = (cs, t1, s1, k) => cs.map(c => ({
  ...c,
  s: Math.max(0, t1 + (c.s - s1) * k),
  e: Math.max(0, t1 + (c.e - s1) * k)
}));- FPS の変換:
t1 = 0, s1 = 0, k = 元の FPS ÷ 動画の FPS(23.976 → 25 なら、k は約 0.959) - 倍率の指定:同じく、
t1 = 0, s1 = 0で、k を直接指定する - 2 点指定:字幕 A と B の、今の開始が
s1、s2。合わせたい時刻がt1、t2。k = (t2 - t1) ÷ (s2 - s1)
1 つの式にしたので、コードが少なく済みました。
動画に合わせる
動画を読み込んで、ズレている字幕の行をクリックします。動画を、その台詞が始まる瞬間で止めて、「Sync selected row to video time」を押します。いまの再生位置と、その字幕の開始との差を、全体のずらしとして適用します。
行ごとに、「開始 = 再生位置」(S)と「終了 = 再生位置」(E)のボタンも付けました。字幕を、1 行ずつ、動画に合わせて作り直すときに使います。
整形
次の項目を、チェックして、まとめて実行できます。
- タグを消す
[..]、(..)、【..】、♪..♪を消す(効果音、話者、歌)- 行の前後の空白と、連続するスペースを整える
- 中身が空の字幕を消す
- 開始時刻の順に並べる
- 同じ文が続いたら、1 つにまとめる(開始が、前の終了から 0.1 秒以内のとき)
- 終了を、次の字幕の開始までに切り詰める
- 短すぎる字幕を、最小の長さまで延ばす(次の字幕の手前まで)
そのほかに、検索と置換(正規表現も可)、改行の解除、指定した文字数での折り返しがあります。
実行する順番は、決まっています(文字の整形 → 空の字幕を消す → 並べ替え → 重複 → 重なり → 最小の長さ)。重なりを直すより先に、並べ替えないと、直し方がおかしくなるためです。
動画のプレビューと、サンプル
動画や音声のファイルを、画面にドロップすると、字幕を重ねて表示します。ブラウザの <video> に、requestAnimationFrame で、現在の再生位置の字幕を出しているだけです。再生中の行は、一覧で、ハイライトされます。
ビープ音つきのサンプル
使い方を説明するだけでは、試せません。そこで、「Load sample」のボタンを付けました。押すと、字幕が 10 行と、30 秒の音声が読み込まれます。
音声は、JS で作っています。8kHz、8bit、モノラルの WAV で、各字幕の開始位置に、880Hz の短いビープを入れています。
// 開始位置から 0.12 秒、減衰する 880Hz のビープ
d[44 + a + i] = 128 + Math.round(60 * Math.sin(2 * Math.PI * 880 * i / sr) * (1 - i / len));
そのため、再生すると、ビープが鳴るのと同時に、字幕が出ます。ここで、SHIFT の「+1s」を押すと、字幕が 1 秒遅れてズレます。耳でも目でも、ズレが分かるので、ズレ補正の練習になります。
サンプルの字幕には、効果音の [BGM]、時間が重なる行、同じ文の連続、短すぎる行、並び順が逆の行、空の行を、わざと入れてあります。整形を、全部オンにして実行すると、10 行が 8 行になります。
一覧の編集と、やり直し
一覧の行は、時刻も本文も、その場で書き換えられます。行ごとに、シーク(▶)、追加(+)、削除(✕)のボタンがあります。
やり直し(Undo)は、操作の前に、字幕の配列を JSON にして取っておく方法です。ファイルごとに、40 段まで取っておきます。字幕の配列は小さいので、この単純な方法にしました(大きなファイルでの重さは、測っていません)。
複数のファイルを読み込んだときは、左の一覧で切り替えます。「apply to all files」にチェックを入れると、ずらしや整形が、全部のファイルに適用されます。
テスト
形式の読み書きと、文字コードは、Node で確認しました。<script> の中身を取り出して、vm で動かします。ブラウザの部品(DOM)が無いと、コアの部分だけが動く作りにしてあるためです。
確認した項目は、次のとおりです。
- 5 つの形式の、相互の往復(SRT → 各形式 → 読み直して、時刻と本文が合う)
- ASS のヘッダーを保って書き出す
- 時刻の読み書き
- UTF-8、UTF-8 BOM、UTF-16 LE、Shift_JIS の書き出しと、自動判定での読み直し
- EUC-JP の判定
- 整形、折り返し、線形補正
- サンプルの字幕が、読めて、整形で 8 行になること
全部で 29 項目で、最初は 1 つ外れました(前に書いた、Shift_JIS の短い文)。画面(DOM、動画のプレビュー、ダイアログ)は、ブラウザで、目で確認しました。
ハマりどころ
1. HTML の {...} は、式として読まれる
整形の説明に、{\an8} と書いたら、画面が Syntax error "a" で落ちました。Astro は、HTML の中の波括弧を、JavaScript の式として読みます。{ と } に書き直しました。<script> と <style> の中は、読まれません。
2. スコープ付きの CSS は、あとから作った要素に効かない
最初に画面を出したら、字幕の行が、スタイルなしで並びました。Astro の <style> は、data-astro-cid-... という属性で、効く範囲を絞っています。JavaScript で、あとから作った要素には、この属性が付かないので、CSS が当たりません。
あとから作る要素(字幕の行、ファイルの一覧、空のときの案内)の CSS は、<style is:global> に移しました。ほかのページに漏れないように、すべて #app の下に限定しました。
3. テストの取り出しが、コメントに引っかかった
テストで、<script is:inline> の中身を、正規表現で取り出していました。ところが、ファイルの先頭のコメントにも、同じ文字列を書いていたので、そちらに先に当たって、動きませんでした。取り出しを、最後の <script> に変えて、直しました。
1 と 2 は、私が書いたコードを、ブラウザで開いて、初めて分かりました。Node のテストでは、見つけられない種類のものです。
未対応のこと
- 数千行の字幕での、表示の速さ:一覧は、全部の行を、画面に作っています。測っていません。遅ければ、見えている分だけ作る方式に変えます
- ASS から、ほかの形式への変換で、位置とスタイルは消えます(斜体・太字・下線は残る)
- ASS のスタイルを編集する画面:ありません。書き出すときの、フォントとサイズを選ぶだけです
- WebVTT の位置の指定(
line:やposition:など)、NOTEとSTYLEのブロック:読み込んだあと、残りません。番号(識別子)も、書き出すときに振り直します - 拡張 LRC の、単語ごとの時刻:未対応です
- 日本語の折り返し:文字数で、均等に割るだけです。ASS のタグの途中で、切れることがあります
- Shift_JIS 以外の古い文字コード(EUC-JP など)への書き出し:未対応です
- 実際の字幕ファイルでの確認:サンプルと、自分で作ったテスト用の文字列だけです。実際のファイルを使うのは、これからです
おわりに
軽いはずの題材でしたが、形式が 5 つあるので、時刻の読み方と、タグの扱いと、文字コードで、思ったより手がかかりました。
一番、効いたのは、「内部の形を 1 つに決める」ことでした。開始と終了のミリ秒と、本文だけにしたので、5 つの形式の読み書きは、それぞれ独立して作れました。ズレの補正も、全部、同じ 1 次式で済みました。
次にやるなら、実際の字幕ファイルで使ってみて、判定の外れや、形式の癖を拾うことです。ただ、これは私の見込みで、どこで外れるかは、まだ分かりません。
実装メモは、docs/subtitle-converter.md に、残してあります。