[Astro] #147 DuckDB WASM をブラウザで動かす — CSV / Parquet 高速集計アナライザーの実装記録
はじめに
ブラウザ上でサーバーを一切介さず、CSV / Parquet / JSON ファイルを SQL でリアルタイム集計できる Web アプリ「DuckDB WASM Data Analyzer」を構築しました。
DuckDB はその列指向エンジンと WASM ビルドの存在により、ブラウザ上でも本格的な分析 SQL を実行できます。100万行の GROUP BY 集計が 91ms で返ってくるほどのパフォーマンスを、サーバーレス・データアップロードなしで実現しています。
| モジュール | 内容 |
|---|---|
| WASM ENGINE | DuckDB WASM 初期化、Web Worker、バンドル選択 |
| FILE LOADER | registerFileHandle によるゼロコピー大容量ファイル登録 |
| QUERY ENGINE | Arrow → JSON 変換、Ctrl+Enter 実行、プリセット SQL |
| VISUALIZER | Chart.js 5種グラフ(BAR / LINE / PIE / SCATTER / TABLE) |
| MULTI FILE | 複数ファイル同時登録、JOIN テンプレート自動生成 |
| EXPORTER | CSV エクスポート、COPY TO + copyFileToBuffer による Parquet エクスポート |
スクリーンショット
メイン UI
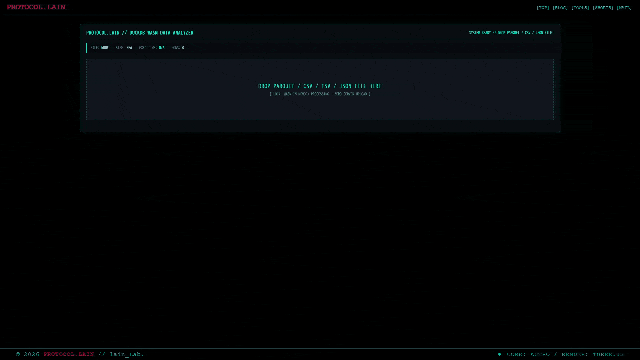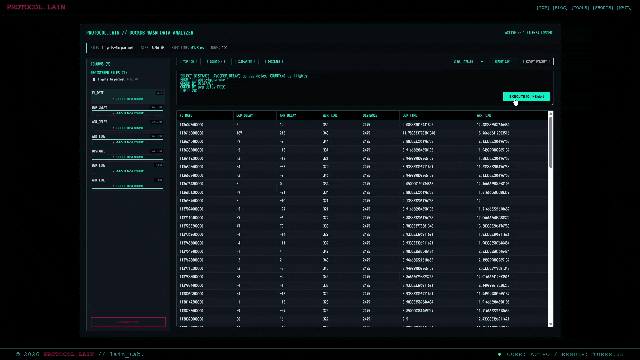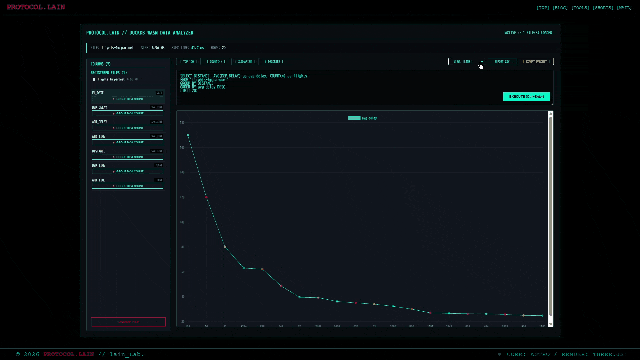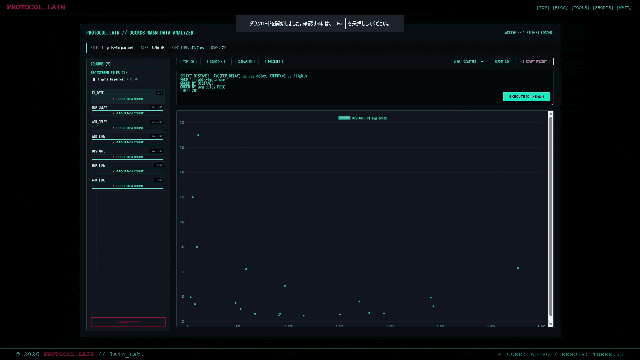
クエリ実行
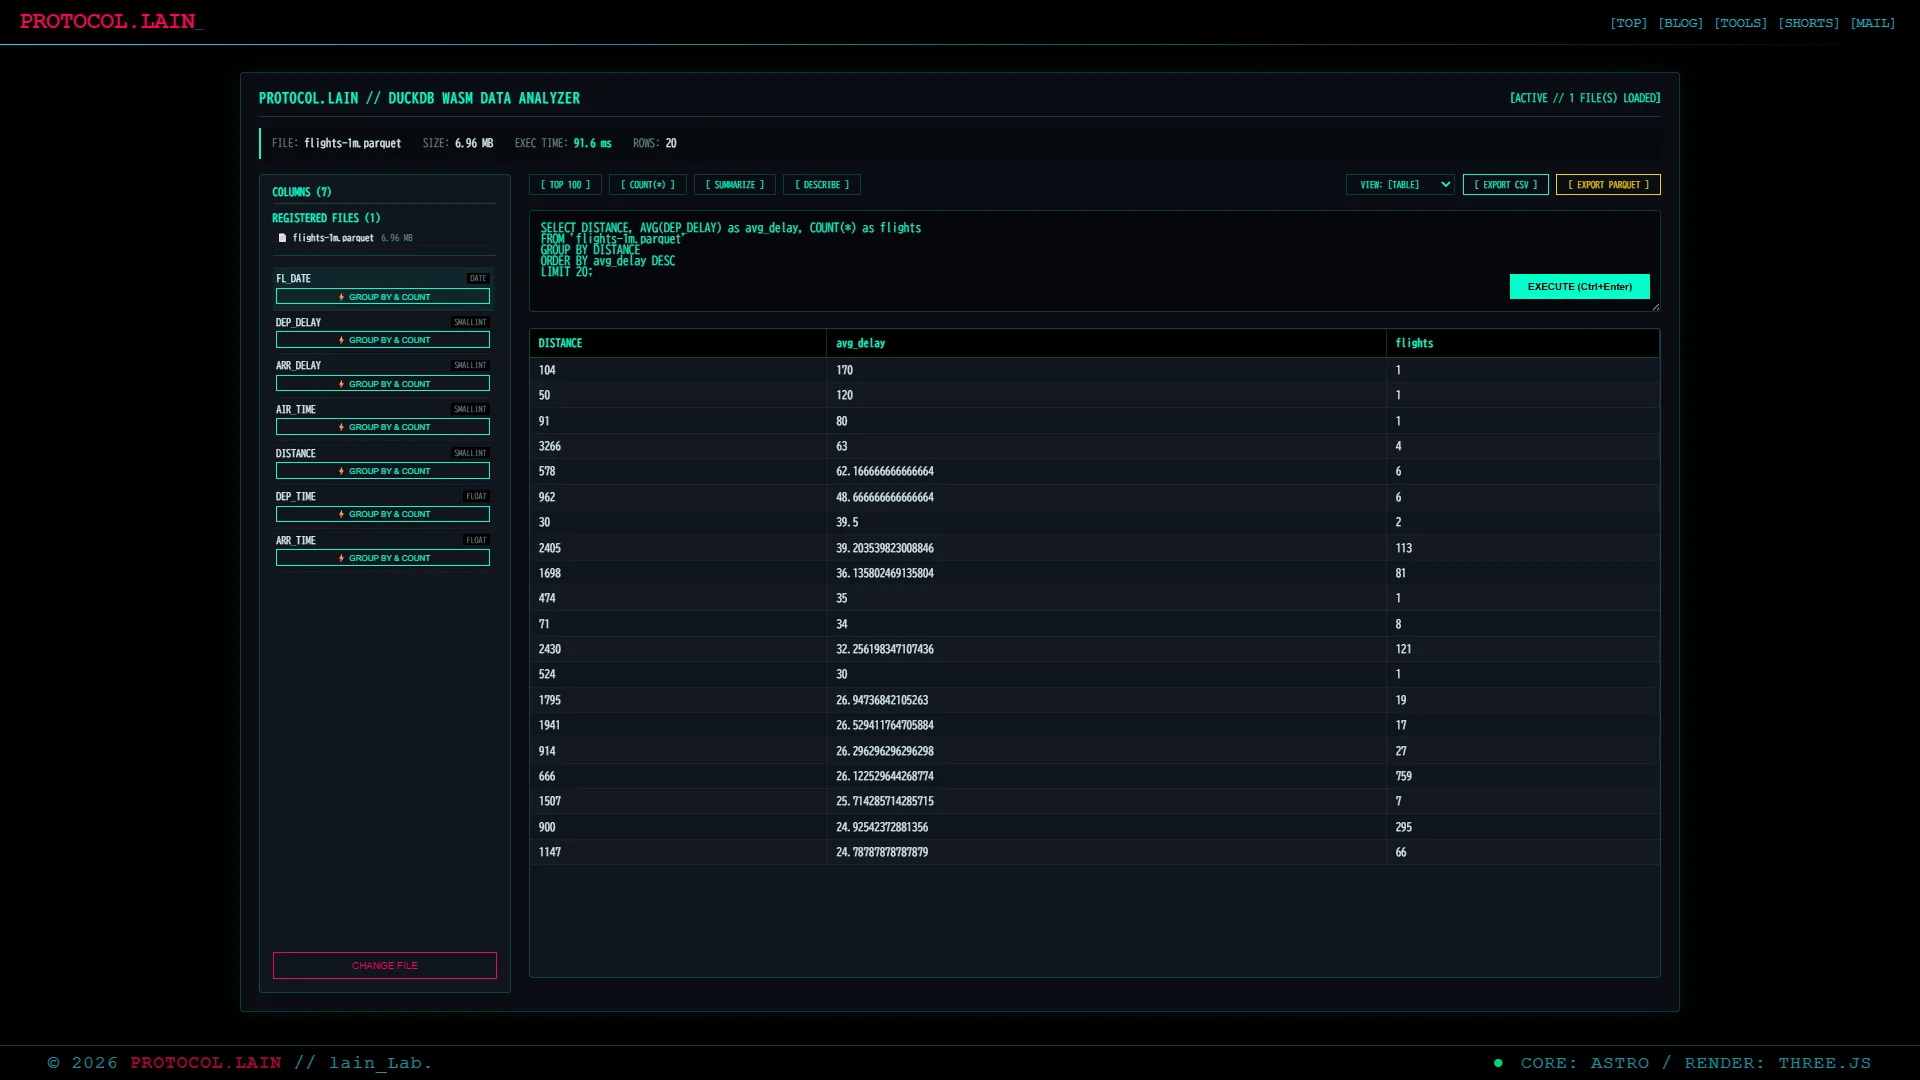
Chart.js グラフ可視化
動画(GIF)
1. 技術スタック
| ライブラリ | バージョン | 役割 |
|---|---|---|
| @duckdb/duckdb-wasm | latest | DuckDB WASM エンジン本体 |
| chart.js | latest | グラフ描画 |
| react-chartjs-2 | latest | React 向け Chart.js ラッパー |
| React | 19 | UI コンポーネント |
| Astro | 5 | ページフレームワーク |
対応ファイル形式: .parquet / .csv / .tsv / .json
2. DuckDB WASM の初期化
DuckDB WASM はメインスレッドをブロックしないよう Web Worker 上で動作させます。CDN からバンドルを取得して環境(マルチスレッド対応 / シングルスレッド)に応じたモジュールを自動選択します。
useEffect(() => {
  const init = async () => {
    // jsDelivr CDN からバンドル情報を取得
    const bundles = duckdb.getJsDelivrBundles();
    // ブラウザ環境に最適なバンドルを選択(SIMD対応等を自動判定)
    const bundle = await duckdb.selectBundle(bundles);

    // Worker スクリプトを動的生成して Web Worker を起動
    const workerBlob = new Blob(
      [`importScripts("${bundle.mainWorker}");`],
      { type: 'text/javascript' }
    );
    const worker = new Worker(URL.createObjectURL(workerBlob));

    const duckDbInstance = new duckdb.AsyncDuckDB(
      new duckdb.ConsoleLogger(),
      worker
    );
    // WASM モジュールをインスタンス化(pthread Worker も同時に起動)
    await duckDbInstance.instantiate(bundle.mainModule, bundle.pthreadWorker);
    // BigInt を Double にキャストして JS で扱いやすくする
    await duckDbInstance.open({ query: { castBigIntToDouble: true } });

    setDb(duckDbInstance);
  };
  init();
}, []);
castBigIntToDouble: true は重要な設定です。JavaScript は BigInt と Number を混在させるとエラーになるため、DuckDB 側で自動変換させることでテーブル表示やグラフ描画の互換性を確保します。
3. ファイル登録と大容量処理
DuckDB WASM は registerFileHandle でブラウザの File オブジェクトを直接 WASM の仮想ファイルシステムに登録します。ファイルの内容をメモリにコピーせず、必要なバイト範囲だけを FileReader 経由で読み込む仕組みです。
await db.registerFileHandle(
  file.name,                                    // 仮想 FS 上のパス
  file,                                         // ブラウザの File オブジェクト
  duckdb.DuckDBDataProtocol.BROWSER_FILEREADER, // FileReader プロトコル
  true                                          // 既存登録を上書き
);
登録後はファイル名をそのまま SQL のテーブルとして参照できます:
SELECT * FROM 'flights-1m.parquet' LIMIT 100;
SELECT COUNT(*) FROM 'data.csv';
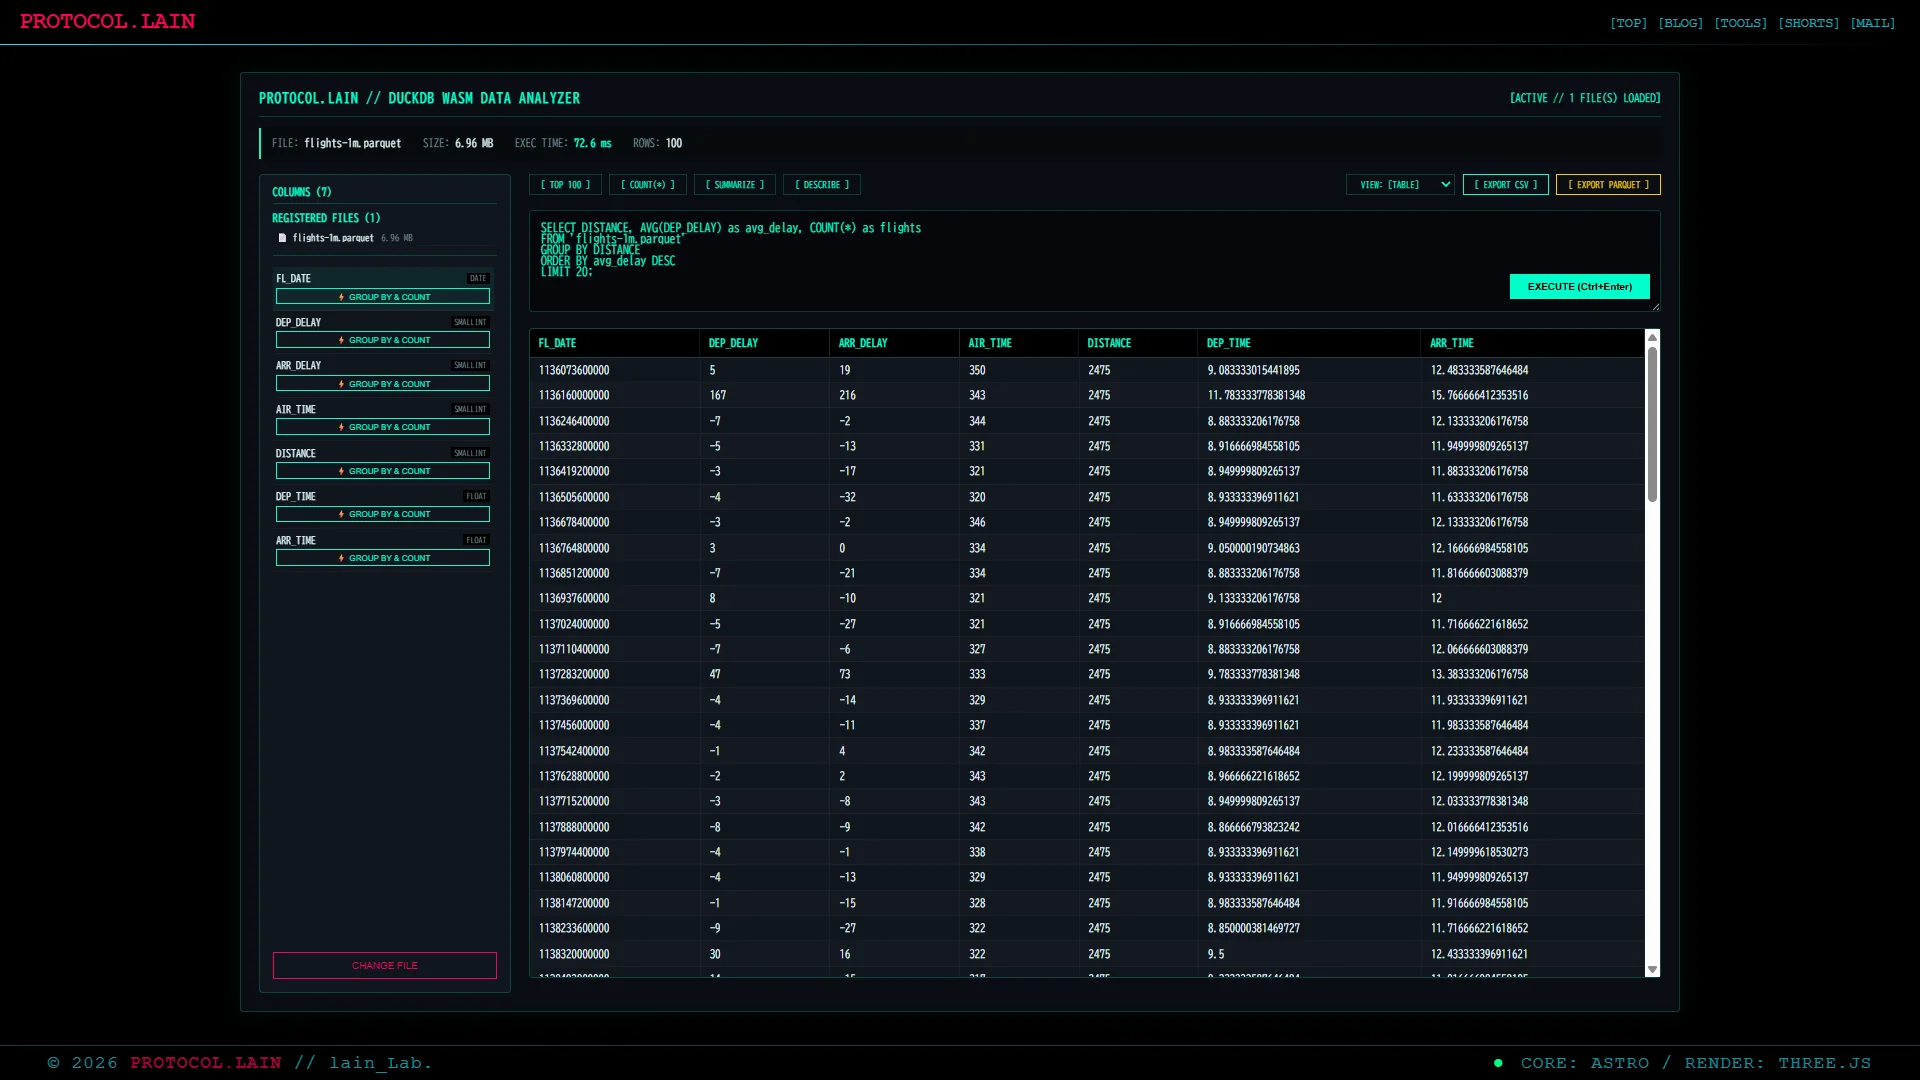
100万行・7MB の Parquet ファイルで初回クエリ(LIMIT 100)が 72ms で返ってくるのは、DuckDB が Parquet のカラムメタデータを先読みして不要な行グループをスキップするためです。
4. クエリ実行と Arrow → JSON 変換
DuckDB WASM のクエリ結果は Apache Arrow 形式で返ってきます。toArray().map(r => r.toJSON()) で各行を通常の JavaScript オブジェクトに変換します。
const conn = await db.connect();
const arrowResult = await conn.query(targetSql);

// Arrow → JavaScript オブジェクト配列に変換
const rows = arrowResult.toArray().map(r => r.toJSON());

// カラム名の抽出
const keys = rows.length > 0 ? Object.keys(rows[0]) : [];
performance.now() で実行時間を計測して UI に表示することで、クエリのパフォーマンスを可視化しています。
5. ワンクリック GROUP BY 集計
左サイドバーのカラムリストから「⚡ GROUP BY & COUNT」ボタンをクリックすると、そのカラムの集計 SQL が即座に生成・実行されます。
const runGroupBy = (colName: string) => {
  const sql = `SELECT ${colName}, COUNT(*) as count
               FROM '${fileName}'
               GROUP BY ${colName}
               ORDER BY count DESC
               LIMIT 50;`;
  setQuery(sql);
  executeQuery(undefined, sql);
};
実際の計測例(100万行の Parquet):
| クエリ | 実行時間 |
|---|---|
SELECT * LIMIT 100 | 72ms |
GROUP BY DISTANCE, AVG(DEP_DELAY) | 91ms |
SUMMARIZE SELECT * | ~300ms |
6. Chart.js による5種グラフ可視化
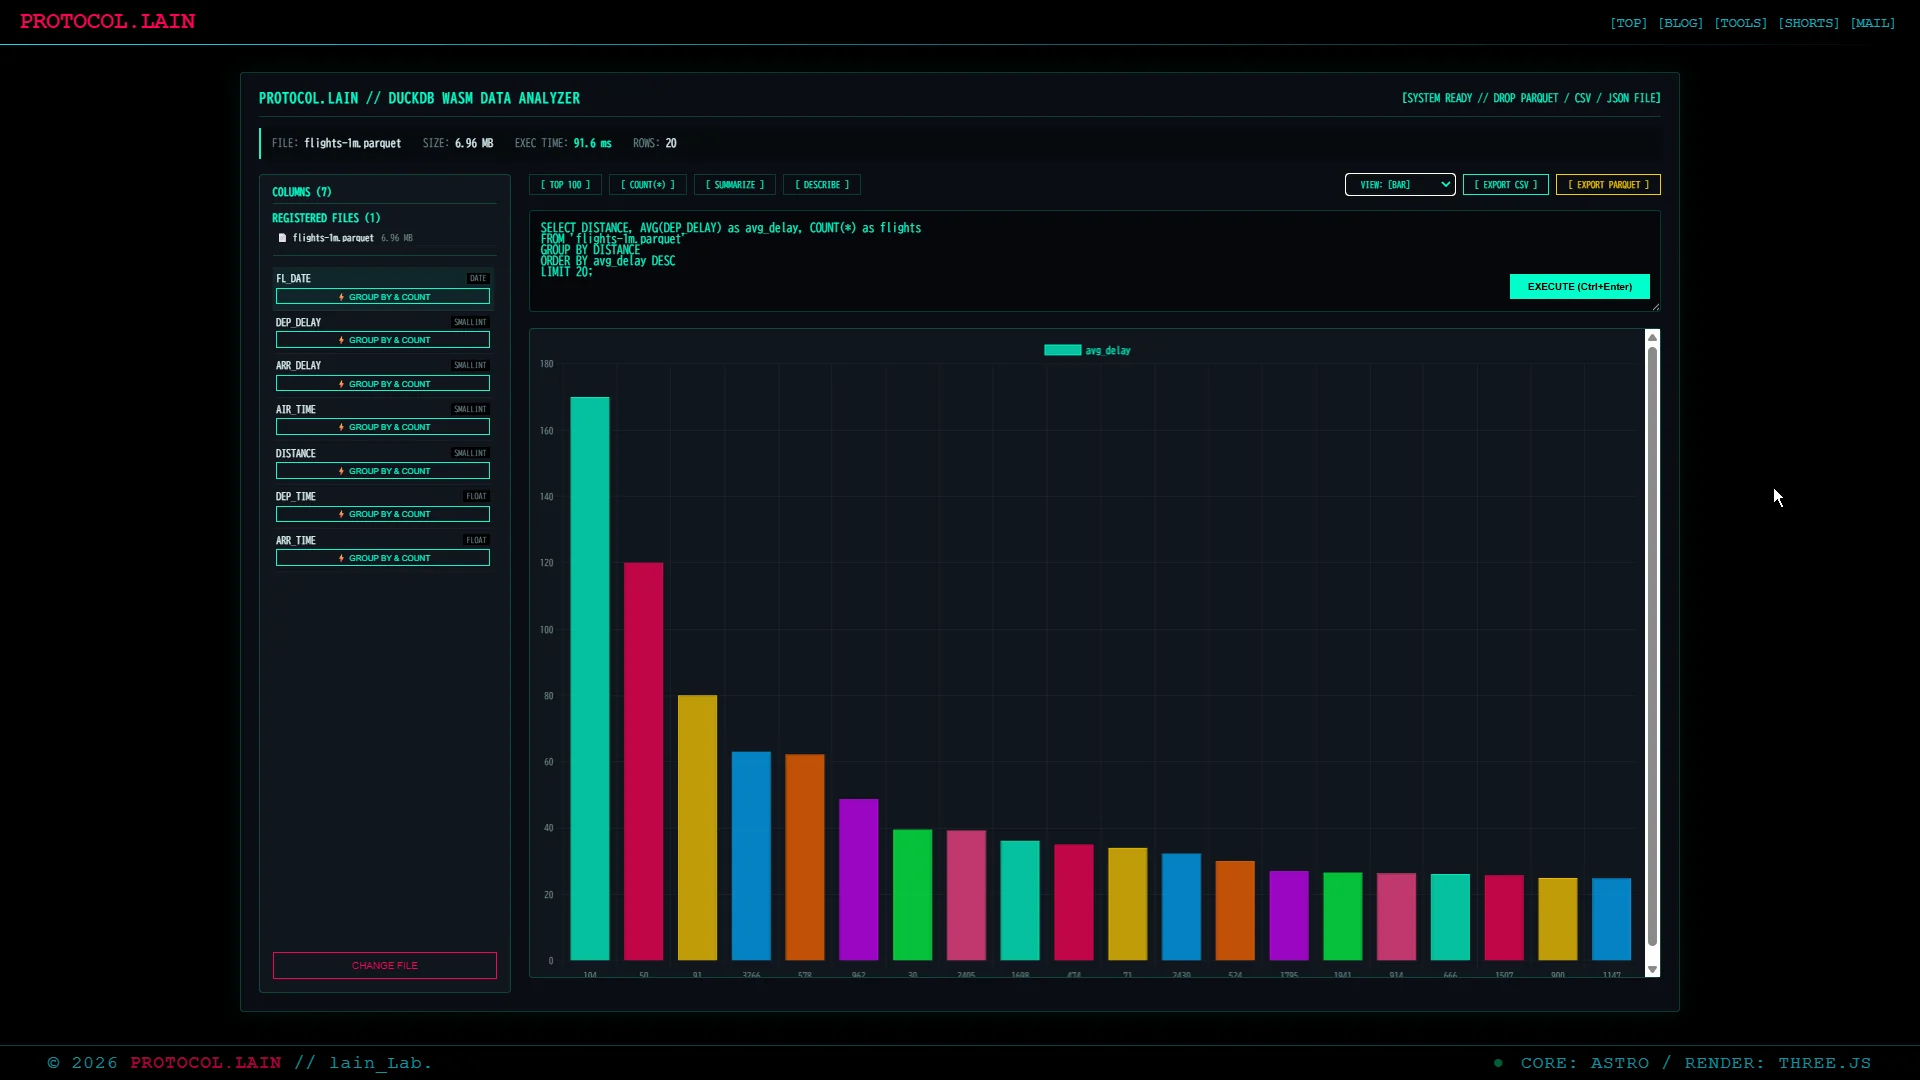
クエリ結果を TABLE / BAR / LINE / PIE / SCATTER の5モードで切り替えて可視化できます。
import {
  Chart as ChartJS,
  CategoryScale, LinearScale, BarElement, LineElement,
  PointElement, ArcElement, Title, Tooltip, Legend
} from 'chart.js';
import { Bar, Line, Pie, Scatter } from 'react-chartjs-2';

ChartJS.register(
  CategoryScale, LinearScale, BarElement, LineElement,
  PointElement, ArcElement, Title, Tooltip, Legend
);
クエリ結果の1列目をラベル(X軸)、2列目を値(Y軸)として自動マッピングします。GROUP BY & COUNT の結果をそのまま流せる設計です。
const chartData = {
  labels: results.slice(0, 50).map(r => String(r[resultKeys[0]] ?? '')),
  datasets: [{
    label: resultKeys[1] ?? '',
    data: results.slice(0, 50).map(r => Number(r[resultKeys[1]]) || 0),
    backgroundColor: chartColors.map(c => c + 'bb'),
    borderColor: chartColors,
    borderWidth: 1,
  }],
};
SCATTER は { x, y } 形式のポイントデータが必要なため、1列目・2列目をそれぞれ数値として読み込む専用の scatterData を用意しています。
7. 複数ファイル登録と JOIN
複数の CSV / Parquet をドロップすることで、registerFileHandle を繰り返し呼んで複数ファイルを仮想 FS に登録できます。各ファイルはそのまま SQL の FROM 句で参照可能なので、JOIN も自然に書けます。
-- 2ファイルを登録した状態でのJOINクエリ例
SELECT a.user_id, a.action, b.status
FROM 'events.csv' a
JOIN 'users.parquet' b ON a.user_id = b.id
LIMIT 100;
UI の「⚡ GENERATE JOIN TEMPLATE」ボタンは最初の2ファイルをもとに JOIN 雛形 SQL を生成します。実際のカラム名に合わせて ON 句を書き換えるだけで使えます。
実装上の注意点として、DuckDB WASM の registerFileHandle は同名ファイルの再登録(overwrite: true)に対応しているため、ファイルを差し替えたい場合も同じファイル名でドロップするだけで済みます。
8. Parquet エクスポート
DuckDB の COPY TO 文で現在のクエリ結果を WASM 仮想 FS 上の Parquet ファイルに書き出し、copyFileToBuffer でバイナリとして取り出してダウンロードします。
const exportParquet = async () => {
  const conn = await db.connect();
  const outName = `export_${Date.now()}.parquet`;

  // 現在の SQL をラップして Parquet として仮想 FS に出力
  await conn.query(
    `COPY (${query.trim().replace(/;$/, '')})
     TO '${outName}' (FORMAT parquet, COMPRESSION snappy);`
  );
  await conn.close();

  // 仮想 FS からバッファを取り出す
  const buf = await db.copyFileToBuffer(outName);
  const blob = new Blob([buf], { type: 'application/octet-stream' });

  // ダウンロードトリガー
  const url = URL.createObjectURL(blob);
  const a = document.createElement('a');
  a.href = url;
  a.download = outName;
  a.click();
  URL.revokeObjectURL(url);
};
Snappy 圧縮を指定しているため、CSV と比較してファイルサイズが大幅に削減されます。GROUP BY の集計結果(4行)を Parquet として出力すると 384バイト になります。出力した Parquet はそのままツールにドロップして再クエリできます。
9. プリセット SQL
DuckDB の分析特化コマンドをワンクリックで実行できるプリセットを用意しています。
| ボタン | SQL | 用途 |
|---|---|---|
| TOP 100 | SELECT * FROM '...' LIMIT 100 | 先頭100行プレビュー |
| COUNT(*) | SELECT COUNT(*) AS total_rows FROM '...' | 総行数確認 |
| SUMMARIZE | SUMMARIZE SELECT * FROM '...' | 全カラムの統計サマリー |
| DESCRIBE | DESCRIBE SELECT * FROM '...' | スキーマ確認 |
特に SUMMARIZE は DuckDB 独自コマンドで、各カラムの min / max / mean / stddev / null 率 / 上位5値などを一括出力します。
10. まとめ
DuckDB WASM はブラウザ完結型のデータ分析ツールとして十分な実用性を持っています。
- 100万行 GROUP BY が 91ms — サーバーなし、アップロードなしでこの速度
- Parquet のネイティブサポート — read / write ともに対応
- 標準 SQL + DuckDB 拡張 —
SUMMARIZE,COPY TO等の分析特化コマンドが使える - 複数ファイル JOIN — 仮想 FS に複数登録して SQL で自由に結合
今後の拡張として、SQLクエリ履歴の保存、HTTP 直読み(SELECT * FROM read_parquet('https://...'))、チャートのX/Y軸カラム指定 UI などを検討しています。