Z80エミュレーター開発記 第4回:ハードウェアバスとエミュレーションの勘所
はじめに
第1回でZ80の誕生の歴史を、第2回でレジスタ構造を、第3回で命令セットのエンコーディングを掘り下げてきた。
最終回となる第4回では、これらの命令が実際のハードウェアバス上でどう動くのか——つまりZ80が外の世界とどうやりとりするのかを解剖し、それをソフトウェアでエミュレートする際の設計方針を議論する。
前回の記事
Z80エミュレーター開発記 第3回:命令セットとプレフィックスデコードのカラクリ // PROTOCOL.LAIN
Z80エミュレーター開発記の最終回。M1サイクルの4 T-state構成(T1-T2でオペコードフェッチ、T3-T4でデコード+DRAMリフレッシュ)、メモリリード/ライトの3 T-state構成、I/Oサイクルの自動ウェイト挿入、WAIT信号の半クロック位相ズレ問題、命令単位エミュレーション vs サイクル単位エミュレーションの精度と性能のトレードオフ、テーブルデコーダーの現実的な性能優位性、コールバック方式によるCPUコアとシステムの分離設計、zexdoc/zexallによる検証戦略、そしてJS/WASMでのZ80コア全体設計を解説する。
lain-lab.com1. マシンサイクルとT-state
Z80のあらゆるバス操作は「マシンサイクル(M-cycle)」という単位で行われる。1つのマシンサイクルは複数の「T-state」(クロックサイクル)から構成される。
Z80には5種類のマシンサイクルがある。
| マシンサイクル | 略称 | T-states | 動作 |
|---|---|---|---|
| オペコードフェッチ | M1 | 4 | PC番地からオペコードを読み、デコードし、DRAMリフレッシュを行う |
| メモリリード | MR | 3 | 指定アドレスからメモリを読む |
| メモリライト | MW | 3 | 指定アドレスにメモリを書く |
| I/Oリード | IOR | 4 | 指定ポートからI/Oを読む(自動ウェイト1挿入) |
| I/Oライト | IOW | 4 | 指定ポートにI/Oを書く(自動ウェイト1挿入) |
1つの命令は1つ以上のマシンサイクルで構成される。例えばNOPはM1の4 T-statesだけで完了するが、LD A, (nn)はM1(4) + MR(3) + MR(3) + MR(3) = 13 T-statesかかる(M1でオペコードを読み、2回のMRで16ビットアドレスnnの下位・上位を読み、最後のMRでnn番地のデータを読む)。
2. M1サイクルの解剖
M1サイクルは全命令の最初に必ず発生するマシンサイクルであり、Z80の動作を理解する上で最も重要な4クロックだ。
M1サイクル (4 T-states):

 T1          T2          T3          T4
 ┌──┐    ┌──┐    ┌──┐    ┌──┐
 │  │    │  │    │  │    │  │
─┘  └────┘  └────┘  └────┘  └──── CLK

 ├─────────────┤ ├─────────────┤
   オペコードフェッチ   デコード+リフレッシュ

T1: PCをアドレスバスに出力、M1信号をアクティブに
T2: MREQ, RDをアクティブに(メモリにリード要求)
    ★ T2の立ち下がりでWAIT信号をサンプル
T3: データバスからオペコードを読み取り
    MREQ, RDを非アクティブに
    → 同時にIRレジスタ(I:R)をアドレスバスに出力
    → RFSH信号をアクティブに
T4: リフレッシュサイクル完了
    → Rレジスタの下位7ビットをインクリメント
    → オペコードのデコードと実行を開始
ここに3つの重要な設計が詰まっている。
-
オペコードフェッチとDRAMリフレッシュの並列化:
T1-T2でオペコードを読み、T3-T4ではCPUがオペコードをデコードしている「隙間」を使ってDRAMリフレッシュを行う。CPUの内部動作と外部バスの動作を巧みに時分割多重化している。第1回で述べた「DRAMリフレッシュの自動化」は、このM1サイクルの設計によって実現されている。 -
WAIT信号のサンプリング:
遅いメモリやI/Oデバイスが「まだ準備できてない」ことをCPUに伝えるWAIT信号は、T2の立ち下がりエッジ(クロックの下降エッジ)でサンプルされる。これは立ち上がりエッジ(上昇エッジ)で動作する他の信号と半クロック位相がずれている。エミュレーターにとっては厄介な問題で、後述する。 -
M1信号の外部利用:
M1信号がアクティブであることは「今オペコードフェッチ中である」ことを外部に知らせる。MSXではこのM1信号を利用してDRAMアクセス速度を調整し、安価なメモリチップでもシステムが動作するようにしていた(M1サイクルに追加のウェイトを自動挿入する)。
3. メモリリード/ライトサイクル
M1以外のメモリアクセスは3 T-statesで完了する。M1より1 T-state短い理由は、リフレッシュサイクルが不要だからだ。
メモリリードサイクル (3 T-states):

T1: アドレスをアドレスバスに出力
T2: MREQ, RDをアクティブに
    ★ WAITサンプリング
T3: データバスからデータを読み取り
    MREQ, RDを非アクティブに
メモリリードのアクセスタイム(メモリが有効なデータを出力するまでの時間)は、M1サイクルでは1.5クロック分しかないのに対し、通常のメモリリードでは2.5クロック分が利用できる。
これがM1サイクルでの「メモリ速度の制約が厳しい」理由であり、MSXがM1サイクルにウェイトを追加した動機でもある。
4. I/Oサイクルと自動ウェイト
I/Oリード/ライトサイクルは4 T-statesで、その中に1 T-stateの自動ウェイトが含まれている。
I/Oリードサイクル (4 T-states):

T1: アドレスをアドレスバスに出力
    ※ I/OではA0-A7がポートアドレス、A8-A15は通常レジスタAの値
T2: IORQをアクティブに, RDをアクティブに
TW: 自動挿入されるウェイトステート
    ★ WAITサンプリング
T3: データバスからデータを読み取り
    IORQ, RDを非アクティブに
Zilogが自動ウェイトを挿入した理由は、IORQがアクティブになってからI/Oデバイスがデコードを完了してWAIT信号を制御するまでの時間が極めて短く、自動ウェイトなしではMOSデバイス(当時の一般的なI/O IC)がフルスピードのCPUに追いつけなかったためだ。
エミュレーターの観点では、I/Oサイクルが自動的に1 T-state長いことを意識してT-stateカウントに反映する必要がある。
5. 割り込みのタイミング
Z80の割り込みは、現在実行中の命令の最後のマシンサイクルの最終T-stateの立ち上がりエッジでサンプルされる。つまり命令の途中では割り込みは認識されない。
命令 LD A, (HL) — 2マシンサイクル、7 T-states:

  M1 (4T)          MR (3T)
┌──┬──┬──┬──┐ ┌──┬──┬──┐
│T1│T2│T3│T4│ │T1│T2│T3│ ← ★ ここのT3立ち上がりでINTサンプル
└──┴──┴──┴──┘ └──┴──┴──┘
NMI(Non-Maskable Interrupt)は同じタイミングでサンプルされるが、IFF1フリップフロップの状態に関係なく常に認識される。NMIが認識されると、IFF1をリセット(割り込み禁止)した上で、PCをスタックにPUSHし、0x0066番地にジャンプする。
割り込みモード1では、INTが認識されるとPCをPUSHし、0x0038番地にジャンプする。
割り込みモード2では、INTが認識されると、データバスから1バイト読み(デバイスが供給するベクタ)、Iレジスタの値を上位バイト、読んだバイトを下位バイトとする16ビットアドレスからワード(2バイト)を読み、そこに格納されたアドレスにジャンプする。
EI命令の直後は、1命令分だけ割り込みが遅延する。これはEI; RETIのようなシーケンスで、EIの直後にRETIを実行する前に割り込みが入ってしまうのを防ぐための仕様だ。エミュレーターではEI実行後に「次の1命令は割り込みチェックをスキップする」フラグを設ける必要がある。
6. エミュレーションの精度レベル
Z80エミュレーターの設計で最初に決めるべきは、どのレベルの精度を目指すかだ。
6.1 命令単位(Instruction-ticked)
命令を1つ読み、デコードし、実行し、消費したT-statesの総数を返す。命令の途中でバスの状態を観測することはできないが、ほとんどの用途にはこれで十分。
// 命令単位エミュレーション
function step() {
  const opcode = readMem(regs.pc++);
  regs.incR();
  // ... デコード&実行 ...
  return tStates; // この命令が消費したT-states
}

// メインループ
function runFrame(cyclesPerFrame) {
  let remaining = cyclesPerFrame;
  while (remaining > 0) {
    remaining -= cpu.step();
  }
}
floooh氏(YAKC/chips)のベンチマークによれば、命令単位のZ80エミュレーターは現代のCPU上で1.2GHz相当のZ80速度(元の約480倍速)を達成できる。1エミュレーション・クロックサイクルあたり2〜3ホストクロックサイクルという効率は、命令をアトミック(不可分)に実行できるからこそ可能な数字であり、サイクル単位では実現不可能な領域だ。
6.2 マシンサイクル単位(M-cycle ticked)
マシンサイクルごとにコールバックを呼び出す。メモリリード/ライト、I/Oリード/ライトのタイミングがマシンサイクル精度で再現される。ほとんどの実機システムのエミュレーション(ZX Spectrum、MSX、Master System等)にはこの精度で十分。
6.3 クロックサイクル単位(Cycle-stepped)
T-stateごとにステップ実行する。WAIT信号やバスリクエスト(BUSREQ)のタイミングを正確に再現できるが、性能コストが大きい。Amstrad CPCのようにゲートアレイとCPUがクロックレベルで同期するシステムのエミュレーションに必要。
WAIT信号の半クロック位相ズレ問題(T2の立ち下がりでサンプルされる)を正しく処理するには、このレベルの精度が必要になる。命令単位やマシンサイクル単位では、WAITのサンプリングを0.5 T-state早くまたは遅くせざるを得ず、位相誤差が生じる。
6.4 実装する精度の選択
今回のエミュレーター開発では、まず命令単位で実装し、zexdoc/zexallテストをパスすることを最初の目標とする。命令単位でも命令の正しさ(レジスタ・フラグの結果)は完全に検証できる。タイミング精度が必要になった段階(特定のシステムのエミュレーションに進む段階)で、マシンサイクル単位にリファクタリングすればよい。
7. コールバック設計:CPUコアとシステムの分離
エミュレーターの設計でもう1つ重要なのは、CPUコアとシステム(メモリマップ、I/Oデバイス、割り込みソース)をどう分離するかだ。
Z80はメモリマップドI/Oではなく、専用のIN/OUT命令によるポートI/Oを持つ(メモリアドレス空間64KBとI/Oアドレス空間256ポートが独立している)。これにより、CPUコアは「メモリの読み書き」と「I/Oの読み書き」を別々のインターフェースとして公開できる。
class Z80 {
  constructor(callbacks) {
    // コールバック: CPUコアはメモリやI/Oの実装を知らない
    this.readMem = callbacks.readMem;     // (addr) => byte
    this.writeMem = callbacks.writeMem;   // (addr, byte) => void
    this.readIO = callbacks.readIO;       // (port) => byte
    this.writeIO = callbacks.writeIO;     // (port, byte) => void
    this.regs = new Z80Registers();
    this.tStates = 0;
  }

  step() {
    const pc = this.regs.pc;
    const opcode = this.readByte(pc);
    this.regs.pc = (pc + 1) & 0xFFFF;
    this.regs.incR();
    this.tStates = 4; // M1サイクルの基本コスト

    this.executeUnprefixed(opcode);
    return this.tStates;
  }

  readByte(addr) {
    return this.readMem(addr & 0xFFFF);
  }

  writeByte(addr, val) {
    this.writeMem(addr & 0xFFFF, val & 0xFF);
    this.tStates += 3; // メモリライトのコスト
  }
  // ...
}

// システム側:例えばシンプルな64KB RAMシステム
const ram = new Uint8Array(65536);
const cpu = new Z80({
  readMem: (addr) => ram[addr],
  writeMem: (addr, val) => { ram[addr] = val; },
  readIO: (port) => 0xFF,           // 未接続ポートは0xFF
  writeIO: (port, val) => {},       // 何もしない
});

// ROMイメージをロード
ram.set(romData, 0x0000);

// 実行
cpu.regs.reset();
while (!cpu.regs.halted) {
  cpu.step();
}
この設計により、同じCPUコアを「ベアメタルのテスト環境」「ZX Spectrumのエミュレーション」「MSXのエミュレーション」など異なるシステムで再利用できる。コールバックの中身を差し替えるだけで、メモリバンキング、ROMライトプロテクト、I/Oポートデコード、割り込みコントローラとの連携がすべてシステム側の責務になる。
8. 検証戦略:zexdoc と zexall
Z80エミュレーターの正しさを検証する事実上の標準テストスイートが、Frank D. Cringle作のzexdoc/zexall(1994年)だ。

ZEXALL — Википедия
ZEXALL — программный тест для микропроцессора Zilog Z80, созданный Frank Cringle в 1994 году. Часто используется создателями эмуляторов для проверки правильности реализации эмуляции этого процессора.
ru.wikipedia.org※ Frank Cringle氏が過去に発表したオリジナルのzexdoc / zexallおよびyazeのソースコードを、Alexander Demin氏がGitHub上にアーカイブ・ミラーとして保存したもの。
GitHub - begoon/z80exer: Frank Cringle's Z80 instruction set exerciser
Frank Cringle's Z80 instruction set exerciser. Contribute to begoon/z80exer development by creating an account on GitHub.
github.comzexdocとzexallはCP/Mの.COM形式で配布されており、実行にはCP/Mのシステムコール(BDOS呼び出し)の最小限のエミュレーションが必要になる。具体的に必要なのは以下の2つだけだ。
// CP/Mの最小BDOSエミュレーション
// CALL 5 (BDOS呼び出し) をトラップする
function handleBDOS(cpu) {
  const func = cpu.regs.c;
  if (func === 2) {
    // C_WRITE: Eレジスタの文字を出力
    process.stdout.write(String.fromCharCode(cpu.regs.e));
  } else if (func === 9) {
    // C_WRITESTR: DEが指すアドレスから'$'まで文字列を出力
    let addr = cpu.regs.de;
    while (true) {
      const ch = ram[addr++];
      if (ch === 0x24) break; // '$'
      process.stdout.write(String.fromCharCode(ch));
    }
  }
}

// アドレス0x0005にRET命令を置き、CALL 5でトラップ
ram[0x0005] = 0xC9; // RET
// → step()の中でPC===0x0005を検出したらhandleBDOSを呼ぶ
zexdocは公式6フラグ(S, Z, H, P/V, N, C)のみを検証し、zexallは非公式フラグ(Y, X)も含めた全8ビットを検証する。実機のZ80上では完了に数時間かかるが、現代のCPU上のエミュレーターでは1分以内に完了する。
テスト結果は命令グループごとにCRC32チェックサムとして表示され、不一致があれば「ERROR」と出力される。全テスト通過の出力は以下のようになる(zexdocの場合)。
Z80doc instruction exerciser
ld hl,(nnnn)................OK
ld sp,(nnnn)................OK
ld (nnnn),hl................OK
...
Tests complete
zexdocを全パスすれば、ほとんどの実用ソフトウェア(ゲーム、アプリケーション)が正しく動作するZ80コアが完成したことになる。zexallの全パスは、非公式フラグとWZレジスタの正確なエミュレーションが要求される、より高い精度の指標だ。
9. 性能の現実:テーブルデコーダー vs パターンデコーダー
第3回でx/y/z/p/qのパターン分解を紹介したが、実際のエミュレーター開発では、このアルゴリズム的デコーダーと巨大なswitch/caseテーブルデコーダーのどちらが速いかが長年議論されてきた。
floooh氏の経験則が示唆的だ。アルゴリズム的デコーダーは「少ないコード量で命令キャッシュに優しいはず」という期待で始まるが、Z80の特殊ケース(同じx/y/zパターンでも命令によって全く違う動作をするもの)を処理するための分岐と間接参照が増え、結局switch/caseの方が2倍速くなるという。
理由は明確で、現代CPUの分岐予測器は巨大なswitch/caseのジャンプテーブルを非常に効率的に処理する一方、アルゴリズム的デコーダーの多段分岐は予測が困難になるからだ。
とはいえ、6502のように命令セットがZ80より遥かに規則的なCPUではアルゴリズム的デコーダーの方が有利になることもあり、これはCPUアーキテクチャとの相性の問題だ。
Z80エミュレーターの最初の実装としてはパターン分解(アルゴリズム的デコーダー)の方が見通しが良く、記事としても説明しやすい。性能が問題になった段階でテーブルデコーダーに移行するのが現実的だ。
10. まとめ:Z80コアの全体像
4回にわたってZ80のアーキテクチャを掘り下げてきた。最後に、エミュレーターの全体設計を1枚の図にまとめる。
┌─────────────────────────────────────────┐
│              Z80 CPU Core               │
│                                         │
│  ┌──────────────┐  ┌──────────────────┐ │
│  │  Registers   │  │   Decoder        │ │
│  │  AF/BC/DE/HL │  │   Unprefixed     │ │
│  │  AF'/BC'/DE' │  │   CB table       │ │
│  │  /HL'        │  │   ED table       │ │
│  │  IX/IY/SP/PC │  │   DD/FD filter   │ │
│  │  I/R/WZ      │  │   DDCB handler   │ │
│  │  IFF1/IFF2   │  └──────────────────┘ │
│  │  IM          │                       │
│  └──────────────┘  ┌──────────────────┐ │
│                    │   ALU            │ │
│                    │   add8/sub8/and8 │ │
│                    │   add16/sbc16    │ │
│                    │   Flag calc      │ │
│                    └──────────────────┘ │
│                                         │
│  Callbacks:                             │
│    readMem(addr) → byte                 │
│    writeMem(addr, byte)                 │
│    readIO(port) → byte                  │
│    writeIO(port, byte)                  │https://localhost:4321/categories/%F0%9F%92%BE-retro_log
└─────────────────────────────────────────┘
              │            │
    ┌─────────┘            └─────────┐
    ▼                                ▼
┌──────────┐                  ┌──────────┐
│  Memory  │                  │  I/O     │
│  (RAM/   │                  │  Devices │
│   ROM)   │                  │          │
└──────────┘                  └──────────┘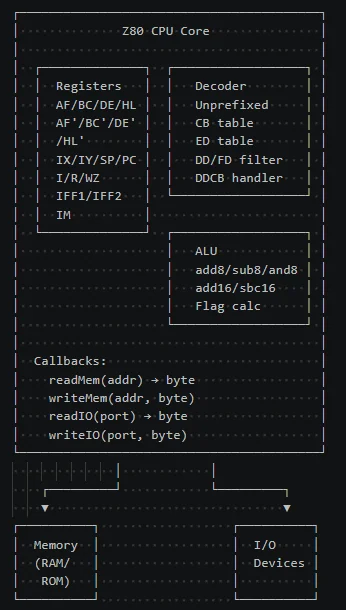
この構造は、第2回のZ80Registersクラス、第3回のデコーダー設計、そして本回のコールバック設計を統合したものだ。 CPUコア自体はメモリやI/Oの実装を一切知らず、コールバックを通じてのみ外界とやりとりする。
この分離により、同じコアを異なるシステム(ZX Spectrum、MSX、ベアメタルテスト環境)で再利用できる。
11. 次のステップ
この連載はここまでが「設計と理解」のフェーズだ。次のステップは実装——実際にJavaScriptでZ80コアを書き、zexdocテストをパスさせることになる。
実装の順序は以下を想定している。
- Z80Registersクラス(第2回で設計済み)
- メモリとI/Oのコールバックインターフェース
- 無プレフィックス命令のデコーダー(x/y/z分解)
- ALU(add8, sub8, and8, … とフラグ計算)
- CB/ED/DD/FDプレフィックスの追加
- 割り込み処理(IM 0/1/2, NMI, EI遅延)
- zexdocのCP/M BDOSトラップと実行
- テスト通過の確認と修正
ここまでが「正しく動くZ80コア」の完成ライン。その先には、特定のシステム(ZX Spectrum、MSXなど)のメモリマップとI/Oを実装してゲームを動かすというフェーズが待っている。
歴史から始まって、レジスタ、命令セット、バスタイミングと進んできたこの連載が、Z80というCPUの設計思想を立体的に理解する手助けになっていれば幸いだ。そしてこの理解は、実際にエミュレーターを書く段階で「なぜこう実装するのか」の根拠として機能するはずだ。
連載構成
| 回 | テーマ | 内容 |
|---|---|---|
| 第1回 | インテルからの独立とZ80誕生の歴史 | ファジンのIntel離脱、Exxonの出資、8080の設計上の負債、Z80の技術革新、CP/Mとの共生 |
| 第2回 | レジスタ構造と「裏レジスタ」の美学 | AF/BC/DE/HL、IX/IY、裏レジスタ、フラグレジスタの全8ビット、WZレジスタ、JSでの設計判断 |
| 第3回 | 命令セットとプレフィックスデコードのカラクリ | x/y/z/p/qパターン分解、CB/ED/DD/FDプレフィックス、DDCB二重プレフィックス、非公式命令 |
| 第4回(本記事) | ハードウェアバスとエミュレーションの勘所 | M1サイクル、I/O自動ウェイト、割り込みタイミング、精度レベル選択、コールバック設計、zexdoc検証 |